本文介绍如何将目标检测、物体分类和实例分割模型部署到 HUSKYLENS 2(二哈识图 2),主要包括「准备数据集 → 训练模型 → 导出 ONNX 模型 → 生成安装包 → 安装到 HUSKYLENS 2」五个步骤。本文提供基础训练代码,并重点介绍模型安装包的生成与安装方法。
1. 自训练模型安装介绍
除了预置的 20 多种视觉识别模型外,HUSKYLENS 2 还支持通过“模型安装”功能,将用户自行训练的目标检测、物体分类和实例分割模型部署到设备中,满足个性化视觉识别项目的需求。
简单来说,如果你想让 HUSKYLENS 2 识别预置模型无法识别的物体(如家中的宠物、某个玩具或特定零件),可以自行收集相关照片、训练模型,再将模型安装到 HUSKYLENS 2。安装完成后,即可像使用预置模型一样使用自训练模型。
如果你需要更多模型,可以先前往模型中心查看是否已有符合项目需求的模型;如果没有合适的模型,再按照本文步骤自行训练和部署。
部署自训练模型主要包括以下步骤:
- 准备数据集:收集并整理需要识别的物体图片,按照规定格式存放。
- 训练模型:在电脑上训练模型。
- 导出模型:将训练得到的模型文件转换为 ONNX 格式。
- 生成安装包:使用官方提供的“模型安装包生成器”,将 ONNX 模型打包为可以在 HUSKYLENS 2 中使用的安装包。
- 安装部署:将安装包复制到 HUSKYLENS 2,完成安装。
下面将分别介绍如何把自训练的目标检测、物体分类和实例分割模型部署到 HUSKYLENS 2。
2. 可安装模型要求
如果你已经有训练好的模型,可以通过本节快速确认该模型能否安装到 HUSKYLENS 2。如果你准备跟随本文从头训练模型,可以先跳过本节,后面的示例均已按照这些要求设置。
| 任务类型 | 支持的模型架构 | 支持的输入尺寸 |
|---|---|---|
| 目标检测 | YOLOv8n、YOLO11n | 224 × 224、320 × 320、640 × 640 |
| 物体分类 | YOLOv8n-cls、YOLO11n-cls | 224 × 224、320 × 320、640 × 640 |
| 实例分割 | YOLOv8n-seg、YOLO11n-seg | 224 × 224、320 × 320、640 × 640 |
模型需要满足以下条件:
- 模型架构:仅支持上表列出的轻量级模型,不支持 YOLOv5、YOLOv8s、YOLO11s 以及其他未列出的模型或变体。
- 输入尺寸:训练和导出 ONNX 时应使用相同的输入尺寸,并且只能选择 224、320 或 640。
- 模型格式:用于生成安装包的模型必须为 ONNX 格式。使用 Ultralytics 训练得到的
best.pt,需要先导出为.onnx文件。 - 配套数据集:除了模型文件,还需要准备用于训练或量化校准的数据集。最好直接使用训练该模型时的数据集;如果原训练数据集已无法获取,也可以另外准备一组能够被模型正确识别的图片,并按照对应任务的 YOLO 数据集格式整理。每个类别建议不少于 10 张图片;对于目标检测和实例分割任务,应准备包含对应类别且标注正确的图片。
如果现有模型符合以上要求,请根据模型的任务类型选择下面对应的安装教程。
3. 软件与硬件准备
开始操作前,请准备以下软件和硬件:
- 将 HUSKYLENS 2 固件升级到最新版本,以正常使用模型安装功能。固件版本查看与烧录教程:点击查看。
- 准备一台运行 Windows 10 或更高版本系统的电脑。HUSKYLENS 2 模型安装包生成器目前仅支持 Windows 10 或更高版本。
- 安装 .NET 7.0 运行环境。请打开 .NET 7.0 下载页面;如果电脑使用 64 位 Windows,请选择 Windows x64 版本下载并安装。
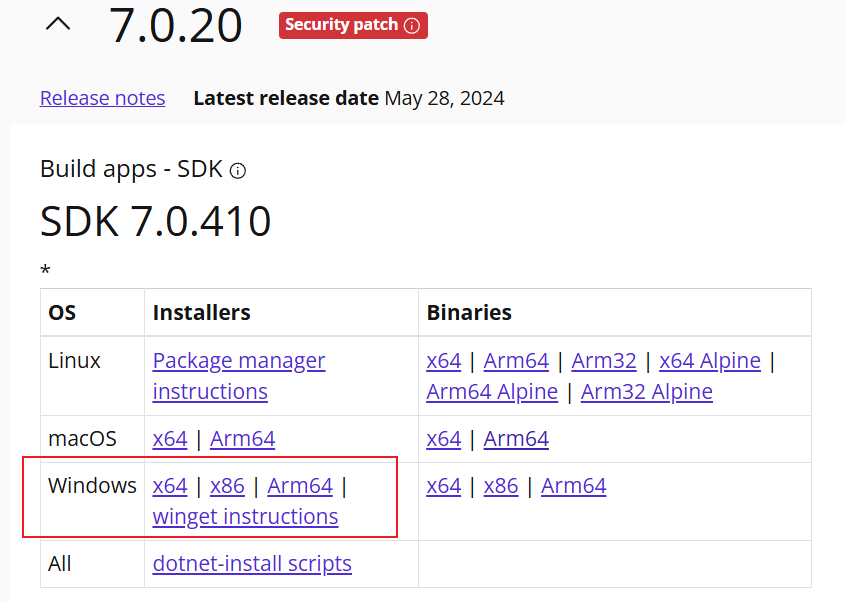
- 下载并解压 HUSKYLENS 2 模型安装包生成器:点击下载。你也可以访问工具源码,自行部署:点击查看源码。
- 准备一根支持数据传输的 USB 线,用于连接电脑与 HUSKYLENS 2,并将生成的 ZIP 安装包复制到设备中。
准备完成后,请根据任务类型查看对应的安装教程。
4. 目标检测模型安装
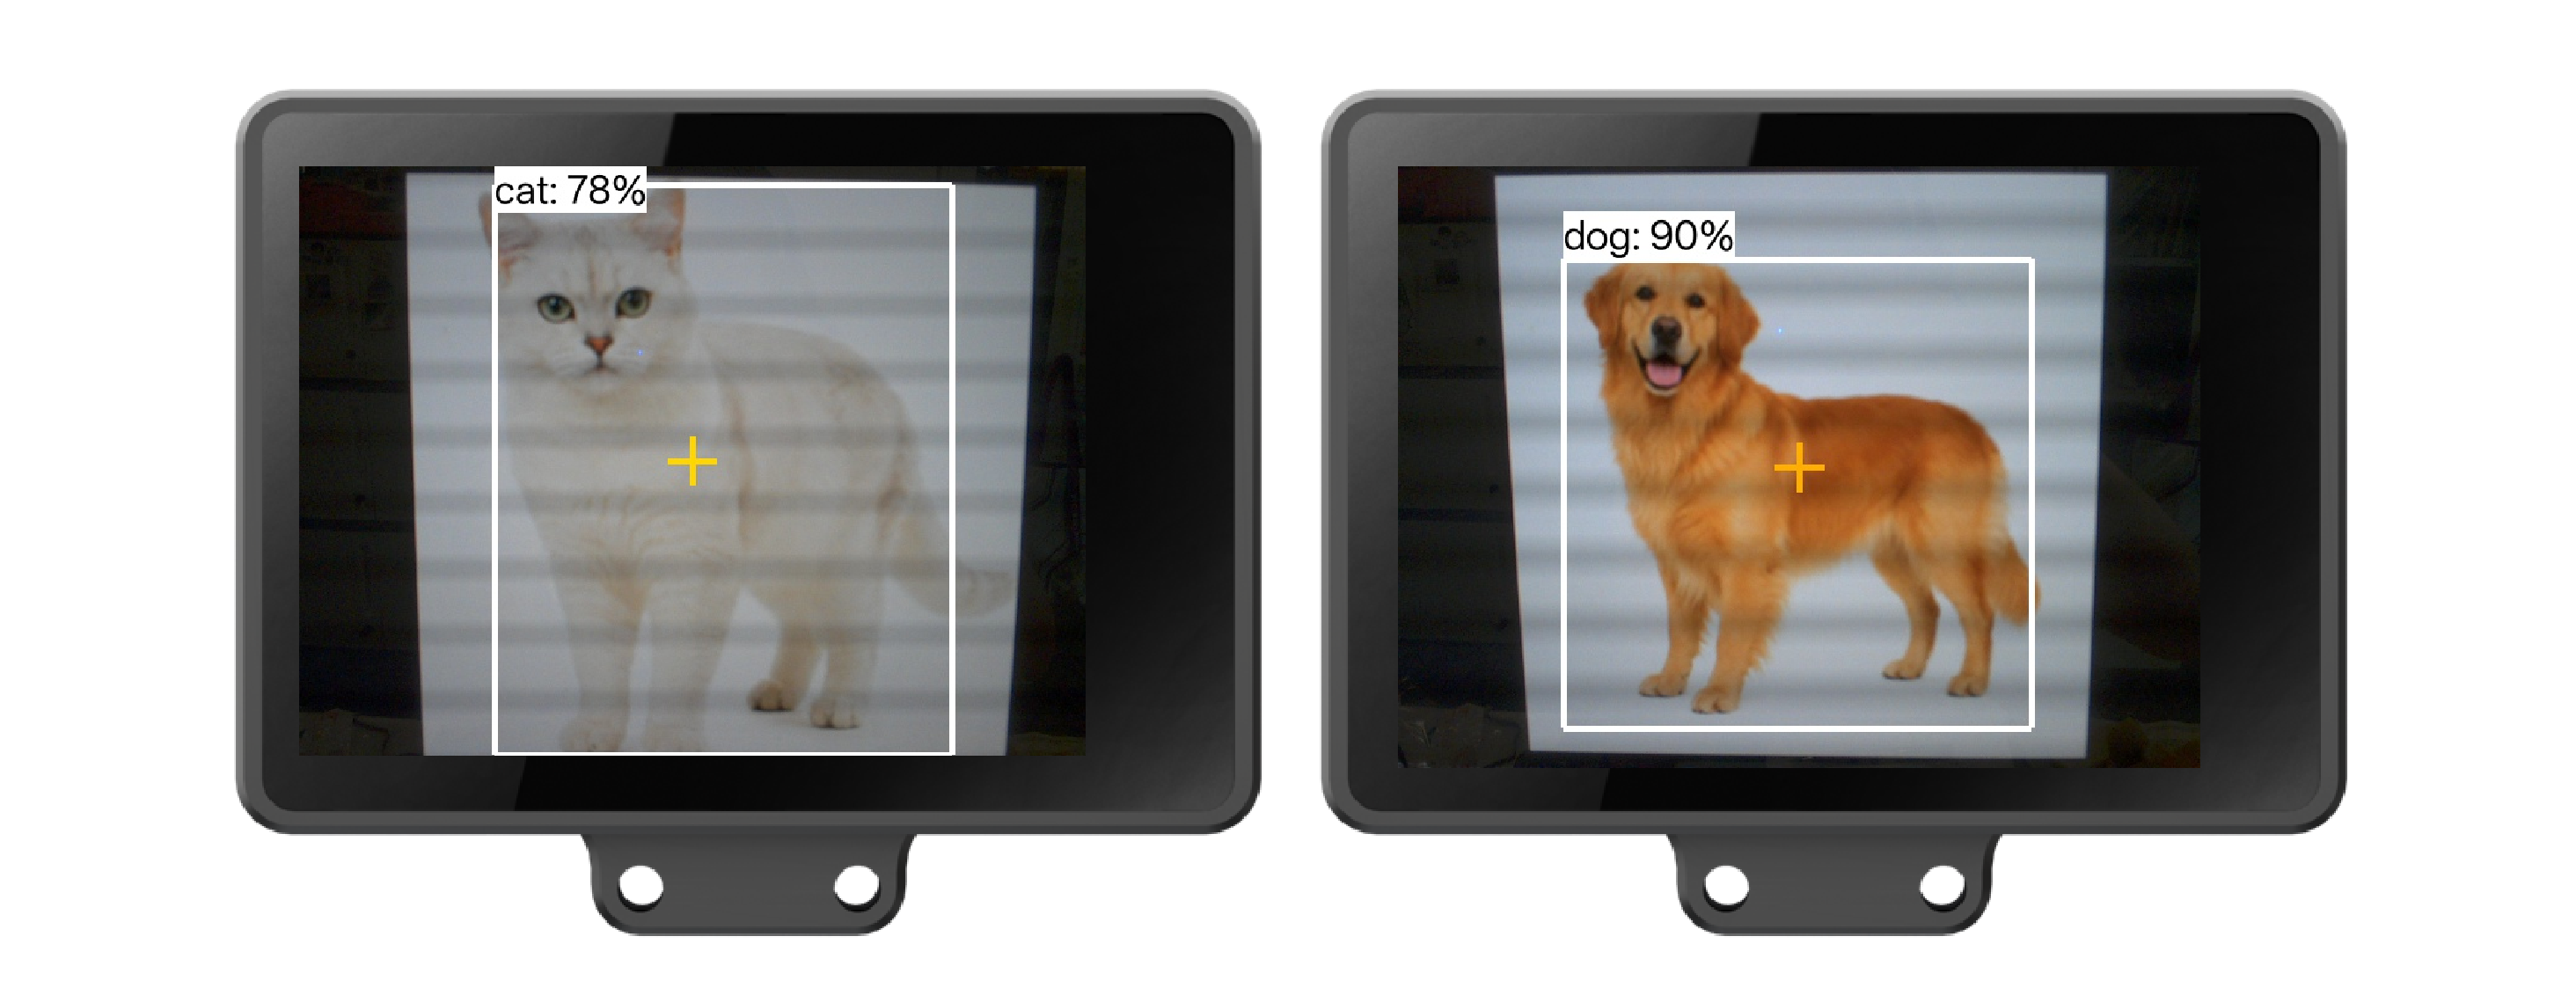
目标检测(Object Detection)是常见的视觉识别任务之一。它不仅能判断画面中“有什么物体”,还能用方框标出每个物体的位置,并给出类别名称和置信度(即模型对判断结果的把握程度)。你可以把它理解为“边识别边画框”:例如摄像头前同时出现猫和狗时,模型会分别框出猫和狗,并标注“猫 0.92”“狗 0.88”等结果。
目标检测模型的特点可以概括为:
- 能同时识别画面中的多个物体,并分别框出每个物体的位置。
- 每个识别结果都包含类别名称、位置框和置信度,方便你后续做判断或控制。
- 特别适合需要“找到物体在哪、是什么”的场景,例如垃圾分类、零件识别、动物识别等。
YOLO(You Only Look Once)是目前常用的目标检测算法之一,具有速度快、精度高、易于上手等特点。HUSKYLENS 2 支持部署 YOLO 系列中的 YOLOv8n 和 YOLO11n 两种轻量级目标检测架构。下面将以 YOLO 目标检测模型为例,介绍训练与部署方法。
4.1 准备 YOLO 目标检测数据集
训练目标检测模型的第一步是准备数据集。数据集可以理解为“给模型看的教材”,其中包含图片,以及图片中物体的位置和类别标注。模型通过反复学习这些“图片 + 标注”,逐步掌握物体识别能力。
HUSKYLENS 2 的模型安装包生成器要求数据集采用标准的 YOLO 格式。一个标准的 YOLO 目标检测数据集,文件夹结构如下:
dataset_dir
├── data.yaml
├── images
│   ├── train
│   │   ├── image_001.jpg
│   │   └── ...
│   └── val                     # 建议保留;用于训练验证,转换时不会读取
│       └── ...
└── labels
    ├── train
    │   ├── image_001.txt
    │   └── ...
    └── val                     # 建议保留;用于训练验证,转换时不会读取
        └── ...
在这个结构中,各文件和文件夹的作用如下:
data.yaml:数据集配置文件,用于定义训练、验证数据的路径和类别名称。images/train:存放训练用的原始图片。labels/train:存放每张图片对应的标注文件。标注文件和图片一一对应、同名,只是扩展名不同:图片叫image_001.jpg,标签就叫image_001.txt。images/val和labels/val:存放验证图片及对应标签。模型安装包生成器不会读取这些文件,但训练时建议保留验证集,用于评估模型效果。
data.yaml(也常命名为 dataset.yaml)的内容示例如下:
path: ./                  # 可选:相对于此 YAML 文件的数据集根目录
train: ./images/train     # 训练图片的路径
val: ./images/val
names:
  0: cat
  1: dog
文件中各项的含义如下:
path:数据集根目录,可以省略。省略时以 YAML 文件所在目录为基准。train:训练图片所在的目录(相对路径)。names:类别编号与名称的对照表,编号从 0 开始依次递增。
这里我们提供一个标准 YOLO 格式的猫狗数据集,可直接用于目标检测模型训练,供你参考:数据集和模型示例
提示:如果你使用常见的标注工具(如 LabelImg、Roboflow 等),请记得把标注结果导出为 YOLO 格式(一张图片对应一个 .txt 文件)。
如需了解 YOLO 目标检测数据集的详细格式、更多示例,以及从其他格式(如 COCO)转换的方法,请参阅 Ultralytics 官方教程:Object Detection Datasets。该文档提供了完整的数据集目录示例和标签格式说明。
4.2 训练目标检测模型
数据集准备好之后,就可以开始训练模型了。训练模型需要一定的 Python 环境和 Ultralytics 库支持,如果你还不熟悉,可以先参考 Ultralytics 官方入门教程:快速入门。
请特别注意以下两点:
- HUSKYLENS 2 仅支持架构为 YOLOv8n 和 YOLO11n 的自训练模型,其他架构(如 YOLOv8s、YOLO11s、YOLOv5 等)都不支持,训练时请只在这两类里选择。
- HUSKYLENS 2 仅支持 224 × 224、320 × 320 和 640 × 640 这三种输入尺寸。
下面给出完整的训练代码示例,只需将其中的路径替换为实际路径:
from ultralytics import YOLO

if __name__ == "__main__":
    # 加载预训练模型
    # HUSKYLENS 2 仅支持 "yolov8n.pt" 和 "yolo11n.pt" 两种,请勿使用其他型号
    model = YOLO("yolov8n.pt")   # 也可以换成 "yolo11n.pt"

    # 训练模型
    # data  : 你自己的 dataset.yaml 文件路径,请替换为实际路径
    # epochs: 训练轮数,可先从 30 开始;轮数过少可能训练不足,过多也可能导致过拟合
    # imgsz : 输入图片尺寸,HUSKYLENS 2 仅支持 224 / 320 / 640
    results = model.train(
        data="path/to/your_dataset.yaml",   # 例如 r"D:\datasets\mydata\dataset.yaml"
        epochs=30,
        imgsz=640,
    )
训练完成后,Ultralytics 默认会在 runs/detect/train/weights/ 目录下生成模型权重文件,其中 best.pt 是效果最好的模型。如果已有同名训练目录,系统可能会自动生成 train2、train3 等带编号的目录。
4.3 导出目标检测 ONNX 模型
训练得到的是 .pt 格式的模型文件,而 HUSKYLENS 2 的模型安装需要 ONNX 格式的模型。因此还需要把 .pt 转换成 .onnx。转换代码如下:
from ultralytics import YOLO

if __name__ == "__main__":
    # 加载训练好的模型权重(请替换成你的 best.pt 实际路径)
    model = YOLO("path/to/best.pt")   # 例如 r"D:\...\runs\detect\train\weights\best.pt"

    # 导出为 ONNX 格式,导出后会在同目录下生成 best.onnx
    # imgsz 需与训练时的输入尺寸保持一致(224 / 320 / 640)
    model.export(format="onnx", imgsz=640)
执行成功后,best.pt 所在目录中会生成 best.onnx 文件,后续生成安装包时将使用该文件。
你可以使用数据集和模型示例,参考上方代码训练猫狗识别目标检测模型。下载的样例数据集中还包含已经训练并导出的 ONNX 模型。
关于训练和导出教程,请参考 Ultralytics 官方教程:Model Training 和 Model Export。
4.4 生成目标检测模型安装包
训练并导出 ONNX 模型后,不能直接将其复制到 HUSKYLENS 2 使用。自训练模型需要通过 HUSKYLENS 2 的模型安装功能,以“安装包”的形式部署。官方提供的 HUSKYLENS 2 模型安装包生成器可将 ONNX 模型打包为 HUSKYLENS 2 能够识别的 ZIP 安装包。
4.4.1 准备 HUSKYLENS 2 模型安装包生成器
如果尚未安装 .NET 7.0 或下载模型安装包生成器,请先按照第 3 节“软件与硬件准备”完成操作。
4.4.2 生成 HUSKYLENS 2 目标检测模型安装包
完成第 3 节的软件与硬件准备后,双击运行 HUSKYLENS2_Package_Generator.exe。工具界面如下。
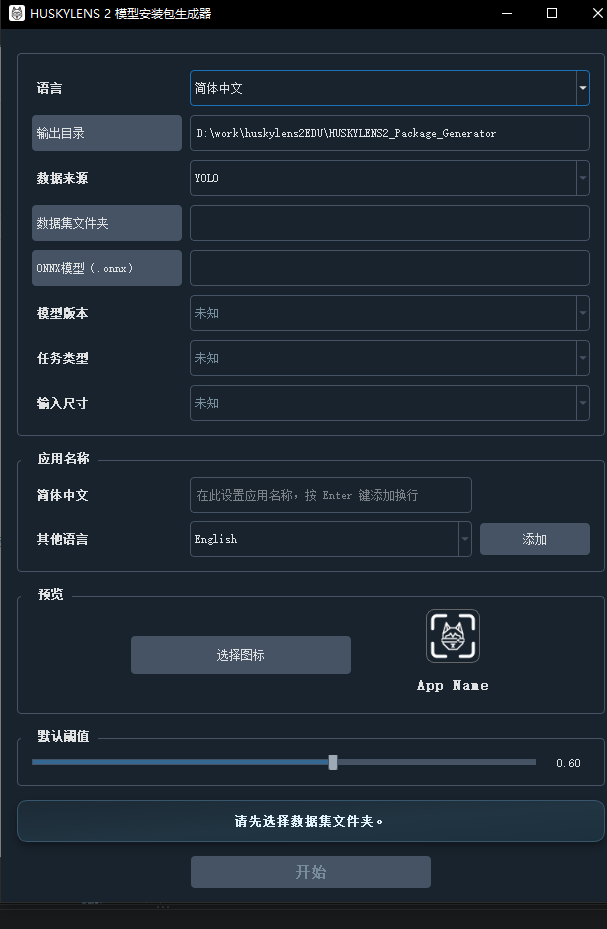
HUSKYLENS2_Package_Generator 的各功能区域及操作步骤如下。
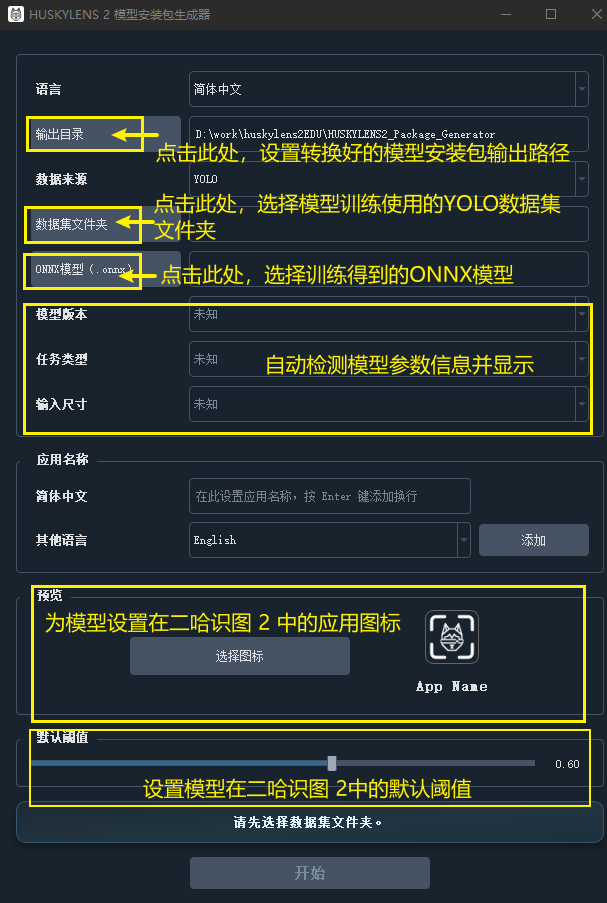
下面以猫狗识别为例,演示生成目标检测模型安装包的完整流程。如果你想跟随示例操作,请下载数据集和模型示例。
开始之前,请先在工具顶部完成以下三项基础设置:
- 选择界面语言:切换到你习惯的语言(支持 English、简体中文、繁體中文等八种语言)。
- 选择输出目录:选择安装包的保存位置,生成的 ZIP 安装包将保存到该目录。
- 选择数据来源:保持默认的 YOLO 即可。
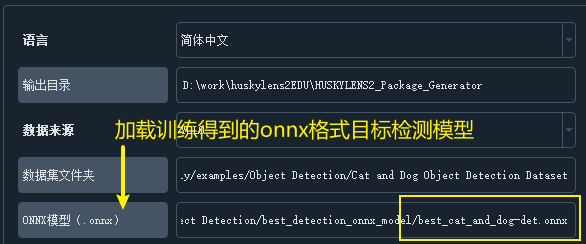
步骤一:选择数据集文件夹
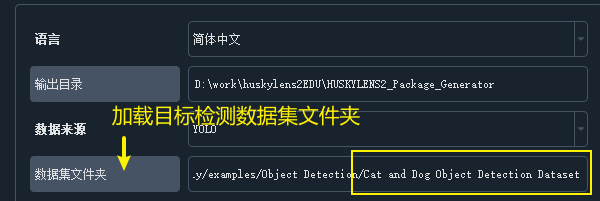
点击 数据集文件夹,找到训练模型时用到的 YOLO 格式数据集文件夹,点击加载。
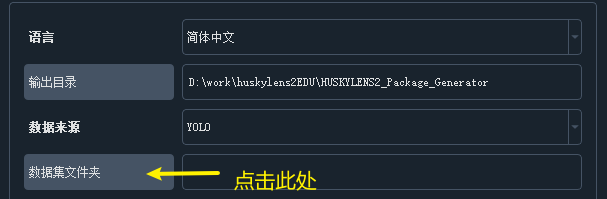
使用样例数据集时,请解压下载文件并选择 sample_datasets/Object Detection/Cat and Dog Object Detection Dataset 文件夹。
步骤二:选择 ONNX 模型
点击 ONNX 模型,选择使用该数据集训练并导出的 ONNX 模型文件,然后加载。
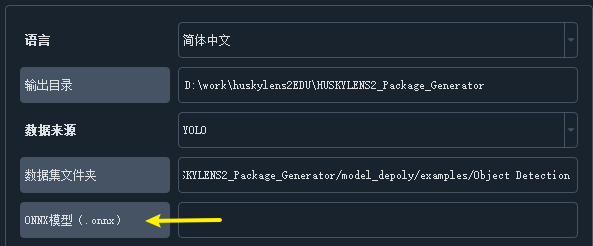
使用样例模型时,请选择 sample_datasets/Object Detection/cat_and_dog-det.onnx。
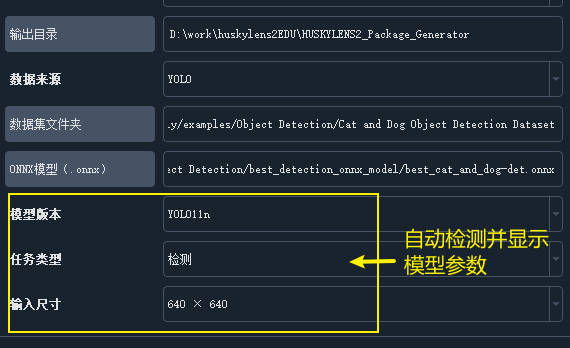
步骤三:确认模型参数信息
加载模型后,工具会自动检测并显示相关参数。请检查参数是否正确,并确认其与训练时的设置一致。
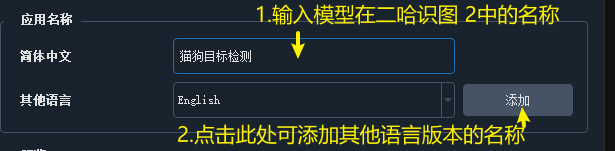
步骤四:完成模型应用在 HUSKYLENS 2 中的相关设置
-
在 应用名称 中设置模型部署到 HUSKYLENS 2 后显示的应用名称,例如
猫狗目标检测。 -
手动换行:输入框输入应用名称时,按 Enter 会插入
\n换行符。 -
自动换行:英文每行最多 12 个字母,中文每行最多 6 个文字,超出部分会自动换行,最多显示两行。
-
点击 添加 可设置其他语言对应的应用名称;用户可添加八种语言中的其他语言名称;未单独填写的语言使用当前默认名称补齐;切换 HUSKYLENS 2 的系统语言时,应用名称也会相应切换。
工具会为模型应用分配默认图标。你也可以点击 选择图标,选择本地图片作为该应用在 HUSKYLENS 2 中显示的图标。
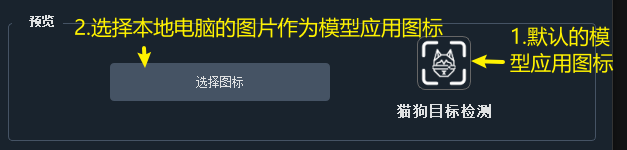
- 应用图标建议使用正方形、透明背景、白色线条的图片(与 HUSKYLENS 2 原生图标风格一致),也支持彩色图标;尺寸为 60 × 60 像素,选择其他尺寸的图片会被自动处理为 60 × 60。
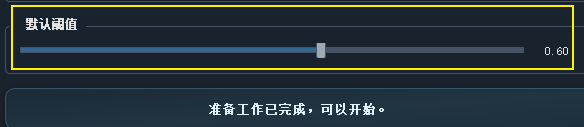
你还可以设置模型在 HUSKYLENS 2 中的默认识别阈值。
步骤五:生成模型安装包
完成以上设置后,点击 开始 生成模型安装包。在生成完成前,请勿关闭工具。
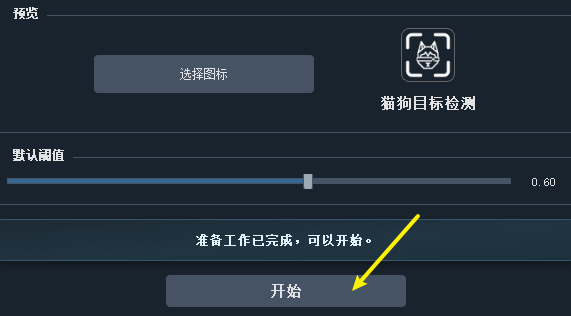
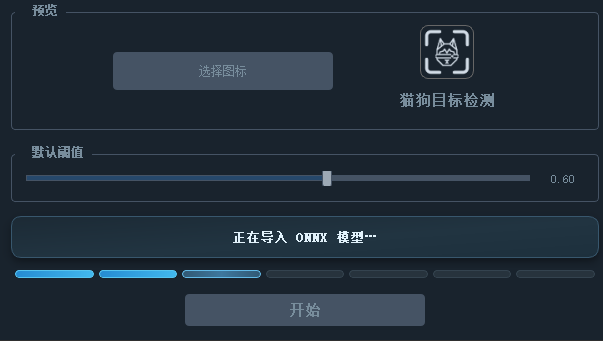
目标检测模型安装包生成成功后,会出现以下提示。
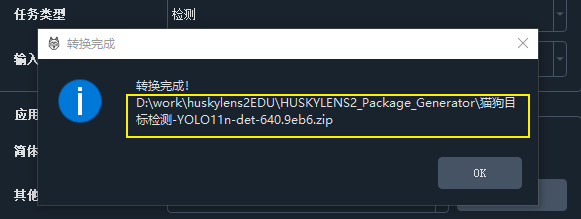
生成的目标检测模型安装包可在所选输出目录中找到。安装包命名格式为“应用名-模型版本-任务类型-输入尺寸.校验码.zip”,例如 猫狗目标检测-YOLO11n-det-640.9eb6.zip。
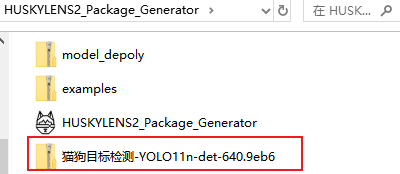
- 请勿修改生成的 ZIP 安装包,包括包内文件和安装包文件名,否则 HUSKYLENS 2 将无法识别该安装包。
4.5 将目标检测模型安装到 HUSKYLENS 2
生成安装包后,即可将其安装到 HUSKYLENS 2:
使用 USB 线将 HUSKYLENS 2 连接到电脑,电脑上会出现一个名为 HUSKYLENS 2 的 U 盘。
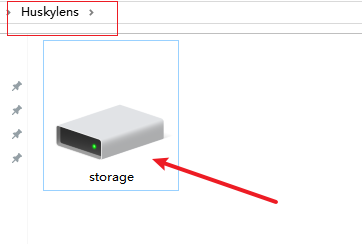
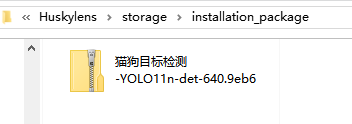
把生成的 ZIP 格式模型安装包复制到 HUSKYLENS 2 U 盘中的以下路径:
Huskylens\storage\installation_package
在 HUSKYLENS 2 屏幕上打开“模型安装(Model Installation)”,然后选择“本地安装(Local Installation)”。
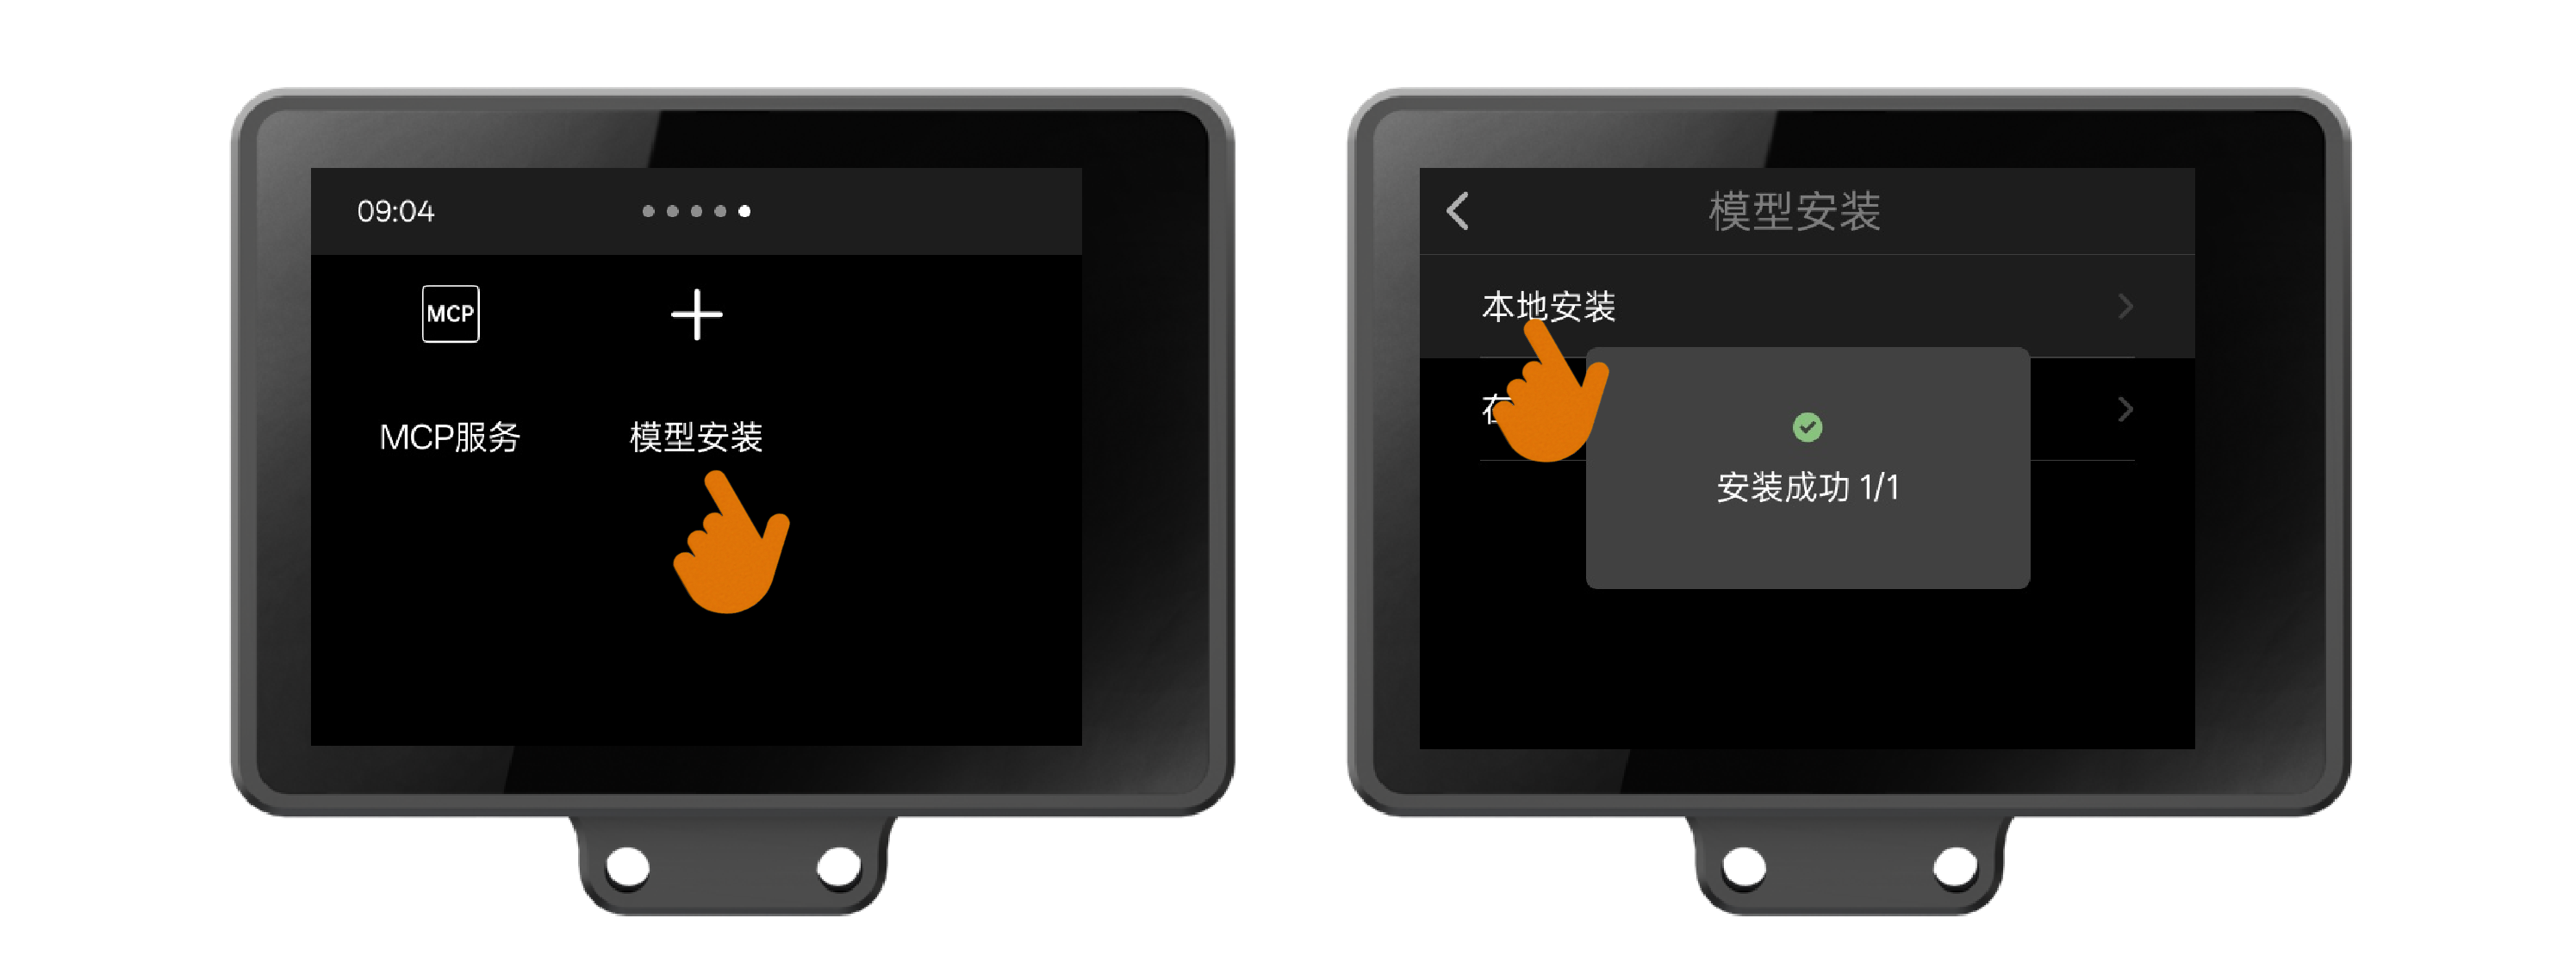
安装完成后,你就可以在功能列表中找到自己训练的目标检测模型了。
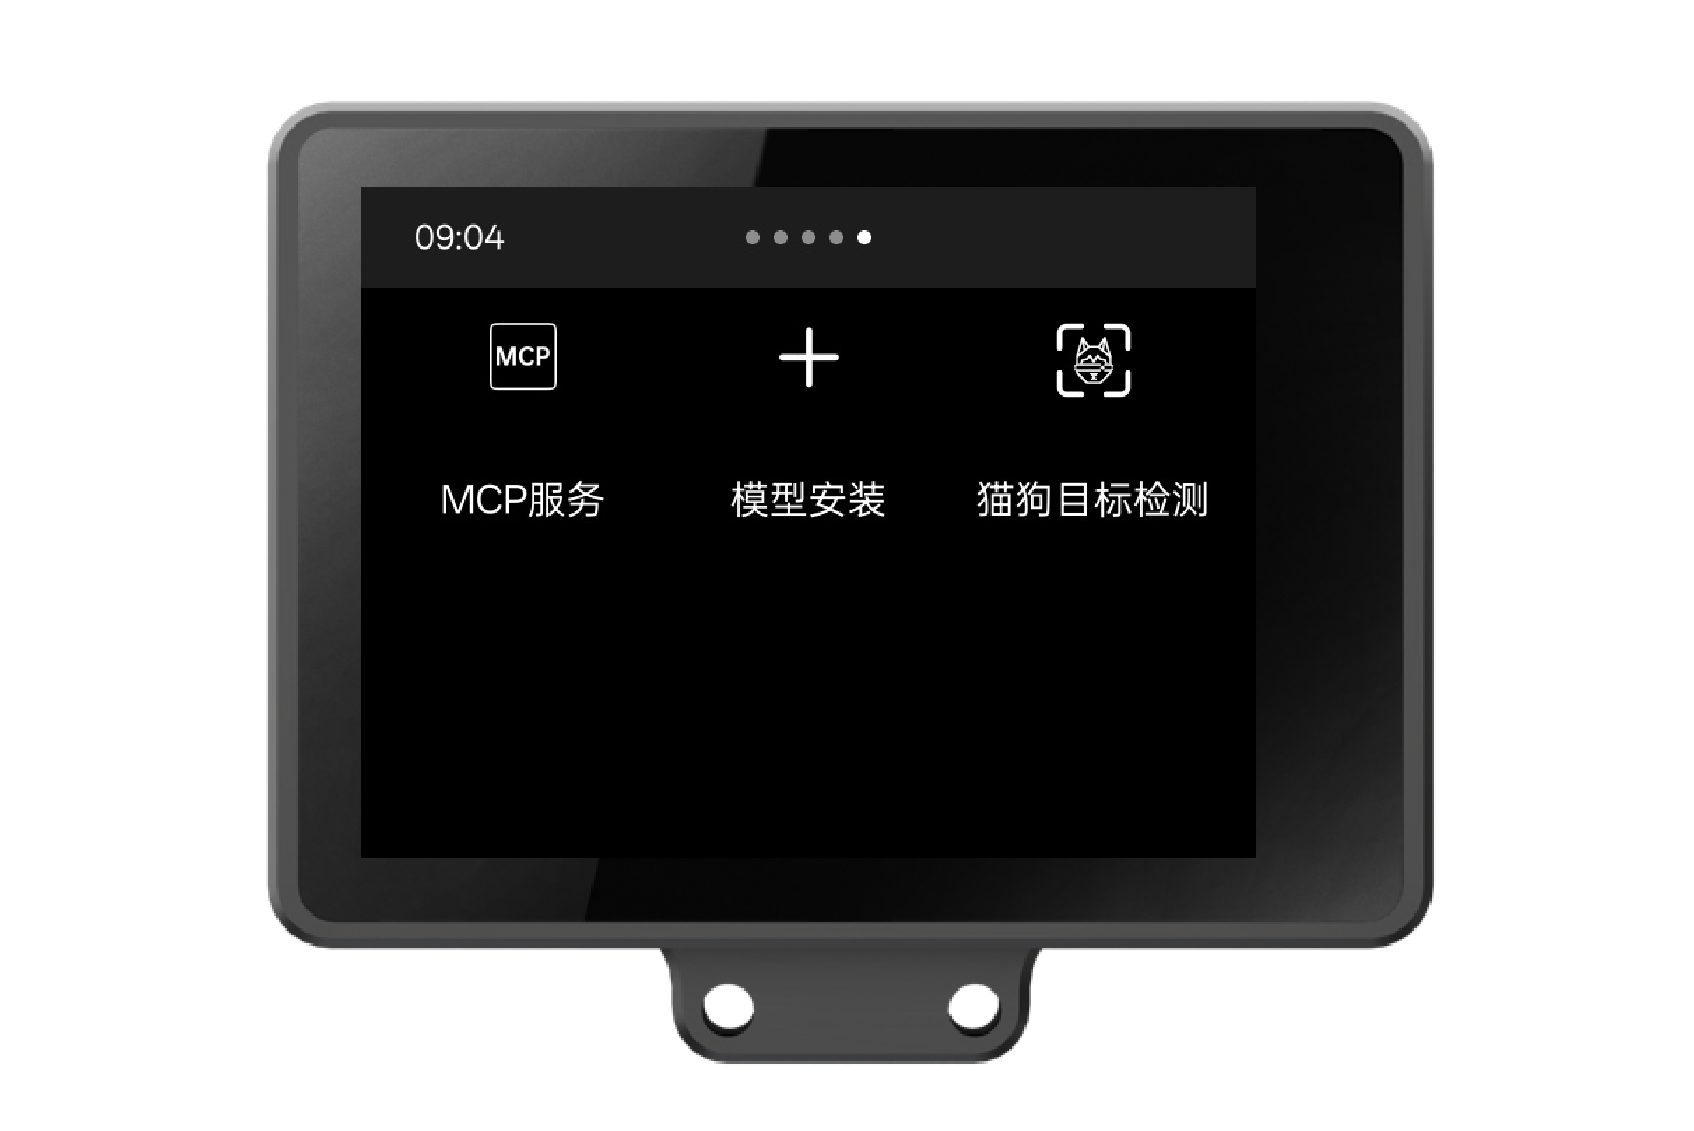
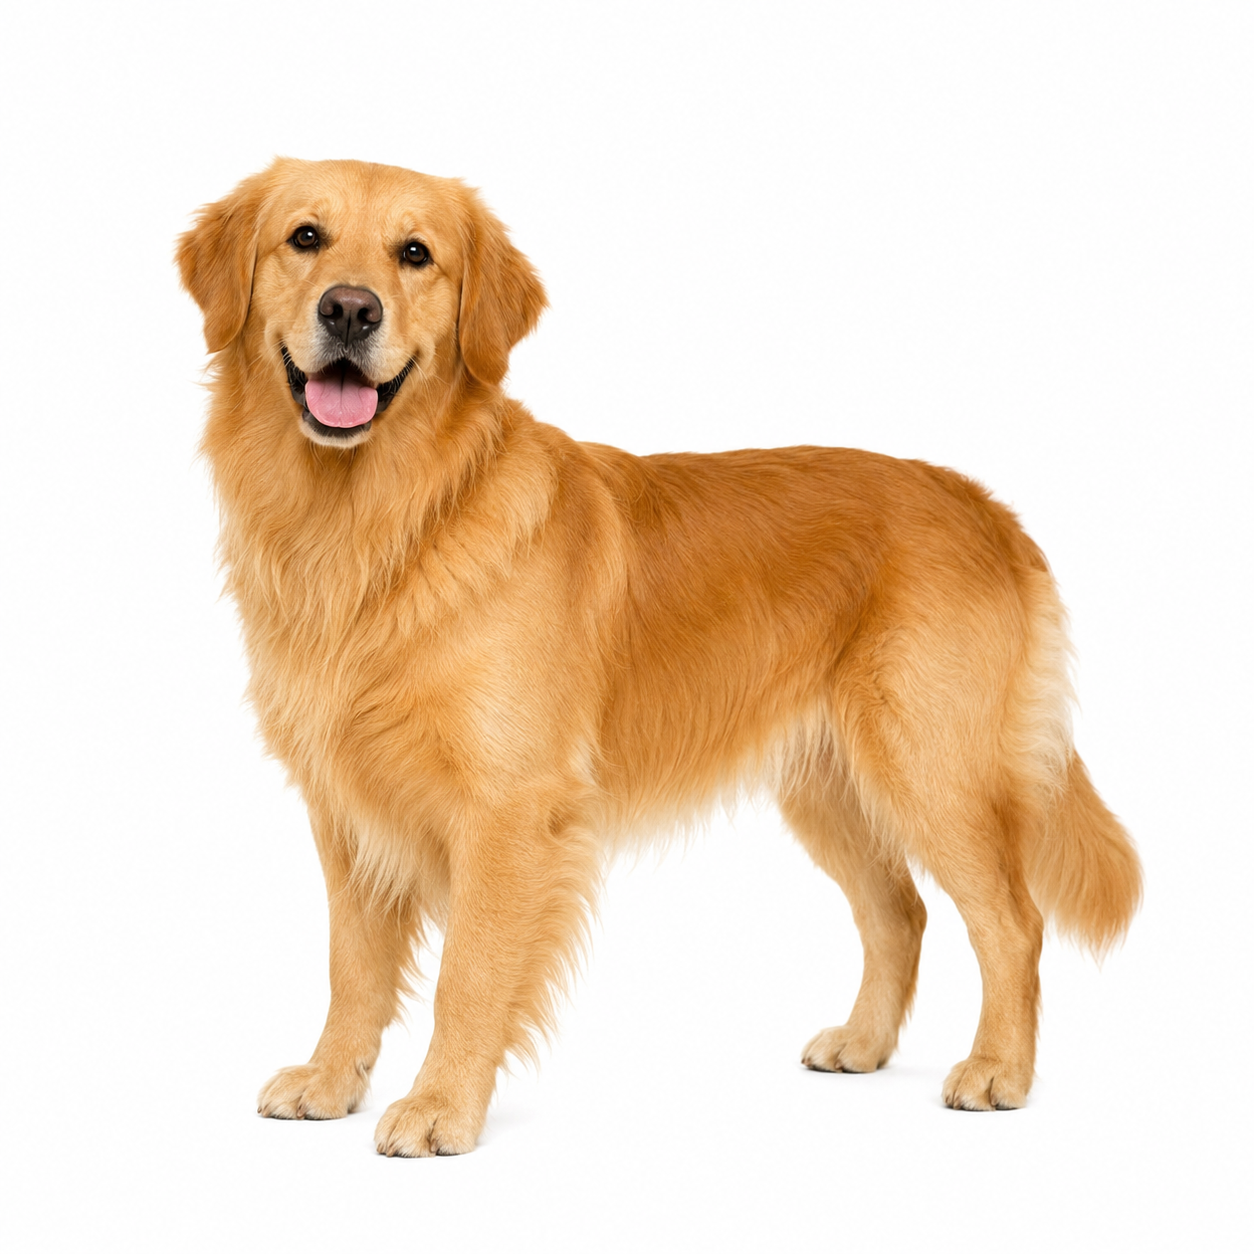
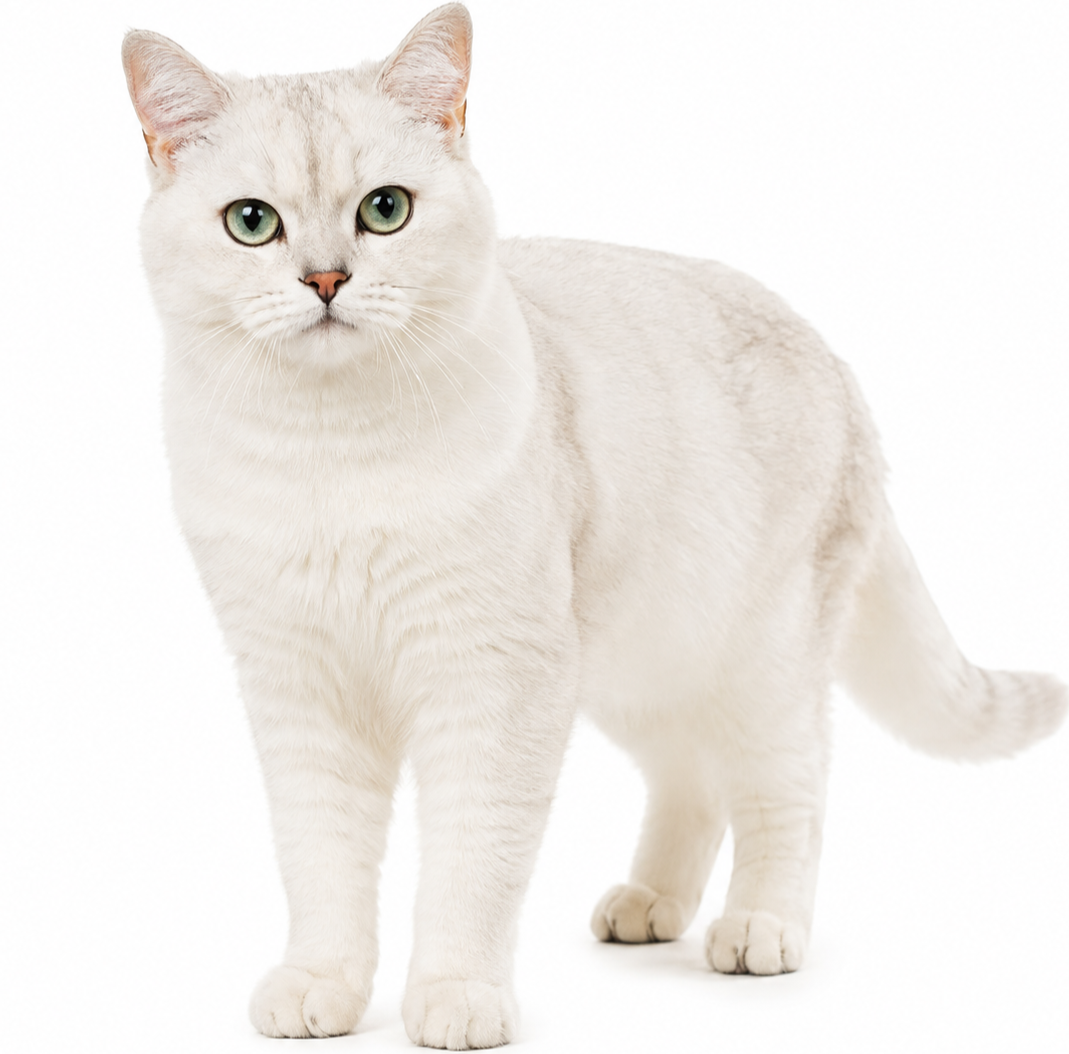
点击模型图标即可观察该模型的检测效果。以下是猫狗识别模型的检测效果。
测试图片如下。
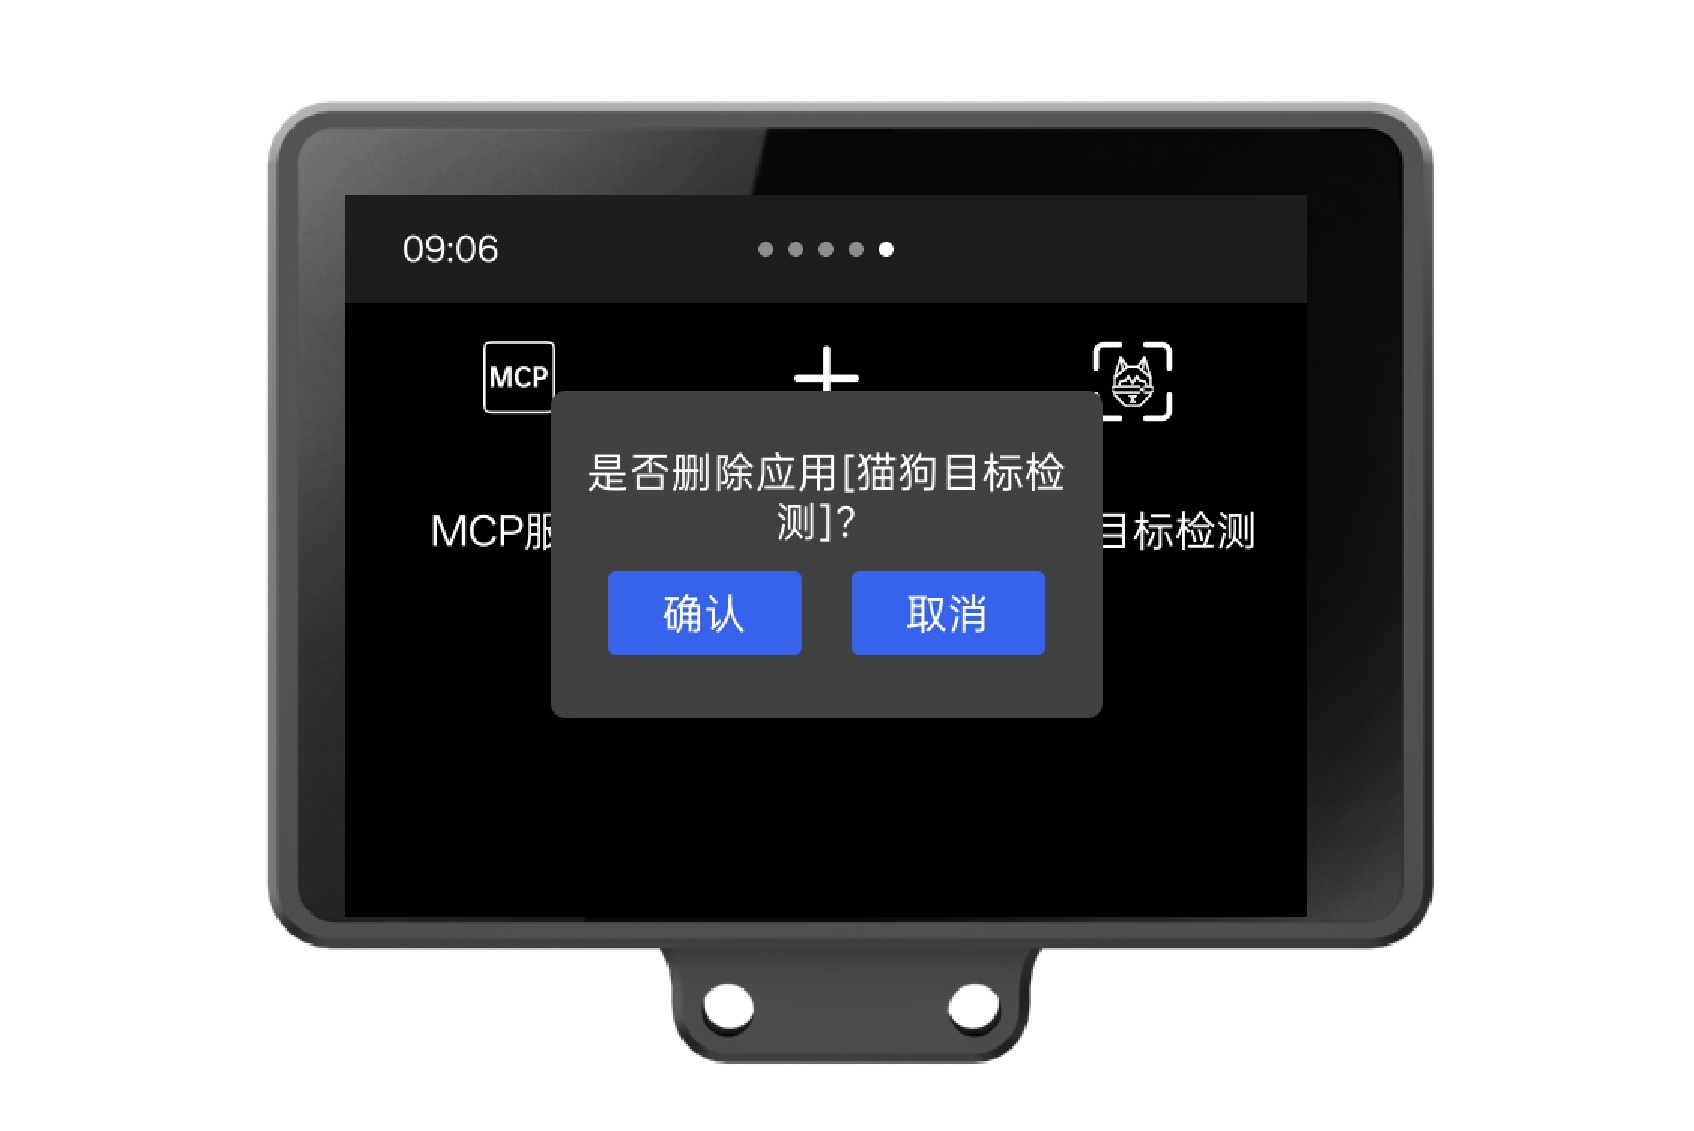
如需删除模型,请在屏幕上找到已部署的自训练模型,长按应用图标,然后按照屏幕提示确认删除。
5. 物体分类模型安装
物体分类(Image Classification)是较为基础的视觉识别任务。它对整张图片给出类别判断,即回答“这张图是什么类别”。输出结果仅包含类别名称和置信度,不会标出物体位置,也不会同时输出多个目标。
物体分类模型的特点可以概括为:
- 只输出一个类别标签和置信度,结果最简单直观。
- 数据集不需要画框标注,制作成本低、上手快。
- 适合“只需要知道这是什么、不需要知道位置”的场景,例如垃圾分类、果蔬分类、宠物种类识别等。
HUSKYLENS 2 支持部署 YOLOv8n-cls 和 YOLO11n-cls 两种轻量级分类架构。下面就以 YOLO 物体分类模型为例,介绍如何训练并部署。
5.1 准备 YOLO 物体分类数据集
物体分类数据集比目标检测数据集更简单,它不需要框选标注。只需将不同类别的图片分别放入对应文件夹,文件夹名称即为类别名称,模型会据此学习各个类别。
一个标准的 YOLO 物体分类数据集,文件夹结构如下:
dataset_dir
├── train
│   ├── class_1
│   │   ├── image_001.jpg
│   │   └── ...
│   └── class_2
│       ├── image_002.jpg
│       └── ...
└── val                       # 建议保留;用于训练验证,转换时不会读取
    └── ...
在这个结构里,每个文件夹的作用如下:
train:存放训练用的图片。class_1/class_2:类别文件夹,文件夹名就是类别名,里面存放对应类别的图片。val:存放验证图片,结构与train相同。模型安装包生成器不会读取该目录,但训练时建议保留验证集,用于评估模型效果。
注意:分类数据集不需要 data.yaml 配置文件,也不需要像目标检测数据集那样准备标签文件。训练时,直接将 data 指向包含 train 文件夹的数据集根目录即可。
这里提供了一个猫狗分类数据集(Cat and Dog Classification Dataset),可直接用于物体分类模型训练:数据集和模型示例。
关于 YOLO 物体分类数据集更详细的格式说明,建议阅读 Ultralytics 官方教程:Image Classification Datasets。
5.2 训练物体分类模型
数据集准备好之后,就可以开始训练模型了。物体分类模型的训练同样使用 Ultralytics 库,如果你还不熟悉,可以先参考 Ultralytics 官方入门教程:快速入门。
请特别注意以下两点:
- HUSKYLENS 2 仅支持架构为 YOLOv8n-cls 和 YOLO11n-cls 的自训练分类模型,其他架构都不支持,训练时请只在这两类里选择。
- HUSKYLENS 2 仅支持 224 × 224、320 × 320 和 640 × 640 这三种输入尺寸。
下面给出完整的训练代码示例,只需将其中的路径替换为实际路径:
from ultralytics import YOLO

if __name__ == "__main__":
    # 加载预训练分类模型
    # HUSKYLENS 2 仅支持 "yolov8n-cls.pt" 和 "yolo11n-cls.pt" 两种,请勿使用其他型号
    model = YOLO("yolov8n-cls.pt")   # 也可以换成 "yolo11n-cls.pt"

    # 训练模型
    # data  : 数据集根目录(包含 train 的那个文件夹),分类任务直接指向文件夹,不是 yaml 文件
    # epochs: 训练轮数,可先从 30 开始;轮数过少可能训练不足,过多也可能导致过拟合
    # imgsz : 输入图片尺寸,HUSKYLENS 2 仅支持 224 / 320 / 640
    results = model.train(
        data="path/to/Cat and Dog Classification Dataset",   # 例如 r"D:\...\Cat and Dog Classification Dataset"
        epochs=30,
        imgsz=640,
    )
训练完成后,Ultralytics 默认会在 runs/classify/train/weights/ 目录下生成模型权重文件,其中 best.pt 是效果最好的模型。如果已有同名训练目录,系统可能会自动生成 train2、train3 等带编号的目录。
5.3 导出物体分类 ONNX 模型
训练得到的是 .pt 格式的模型文件,而 HUSKYLENS 2 的模型安装需要 ONNX 格式的模型。因此还需要把 .pt 转换成 .onnx。转换代码如下:
from ultralytics import YOLO

if __name__ == "__main__":
    # 加载训练好的分类模型权重(请替换成你的 best.pt 实际路径)
    model = YOLO("path/to/best.pt")   # 例如 r"D:\...\runs\classify\train\weights\best.pt"

    # 导出为 ONNX 格式,导出后会在同目录下生成 best.onnx
    # imgsz 需与训练时的输入尺寸保持一致(224 / 320 / 640)
    model.export(format="onnx", imgsz=640)
执行成功后,best.pt 所在目录中会生成 best.onnx 文件,后续生成安装包时将使用该文件。
你可以使用数据集和模型示例,参考上方代码训练猫狗分类模型。下载的样例文件中还包含已经训练并导出的 ONNX 模型。
关于训练和导出教程,请参考 Ultralytics 官方分类任务教程:Image Classification。
5.4 生成物体分类模型安装包
训练并导出 ONNX 模型后,同样需要将其打包为 HUSKYLENS 2 能够识别的 ZIP 安装包。这里使用的仍是第 3 节介绍的 HUSKYLENS 2 模型安装包生成器。
5.4.1 准备 HUSKYLENS 2 模型安装包生成器
如果尚未安装 .NET 7.0 或下载模型安装包生成器,请先按照第 3 节“软件与硬件准备”完成操作。
5.4.2 生成 HUSKYLENS 2 物体分类模型安装包
完成第 3 节的软件与硬件准备后,双击运行 HUSKYLENS2_Package_Generator.exe。工具界面如下。
HUSKYLENS2_Package_Generator 的各功能区域及操作步骤如下。
下面以猫狗分类为例,演示生成物体分类模型安装包的完整流程。如果你想跟随示例操作,请下载数据集和模型示例。
开始之前,请先在工具顶部完成以下三项基础设置:
- 选择界面语言:切换到你习惯的语言(支持 English、简体中文、繁體中文等八种语言)。
- 选择输出目录:选择安装包的保存位置,生成的 ZIP 安装包将保存到该目录。
- 选择数据来源:保持默认的 YOLO 即可。
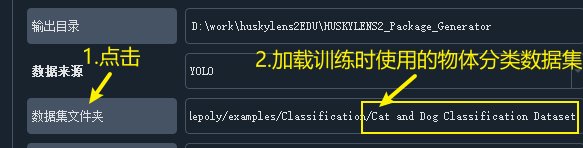
步骤一:选择数据集文件夹
点击 数据集文件夹,选择并加载分类数据集文件夹。使用样例数据集时,请选择 sample_datasets/Classification/Cat and Dog Classification Dataset 文件夹。
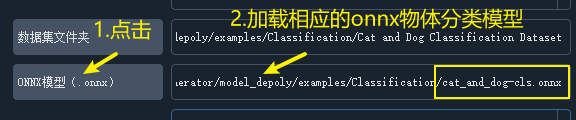
步骤二:选择 ONNX 模型
点击 ONNX 模型,选择并加载使用该数据集训练并导出的分类 ONNX 模型文件。使用样例模型时,请选择 sample_datasets/Classification/cat_and_dog-cls.onnx。
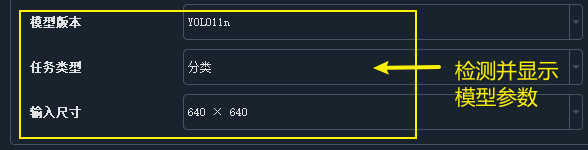
步骤三:确认模型参数信息
加载模型后,工具会自动检测并显示相关参数。请检查参数是否正确,并确认其与训练时的设置一致。对于分类任务,请确认“任务类型”显示为“分类”。
步骤四:完成模型应用在 HUSKYLENS 2 中的相关设置
-
在 应用名称 中设置模型部署到 HUSKYLENS 2 后显示的应用名称,例如
猫狗物体分类。 -
手动换行:输入框输入应用名称时,按 Enter 会插入
\n换行符。 -
自动换行:英文每行最多 12 个字母,中文每行最多 6 个文字,超出部分会自动换行,最多显示两行。
-
点击 添加 可设置其他语言对应的应用名称;用户可添加八种语言中的其他语言名称;未单独填写的语言使用当前默认名称补齐;切换 HUSKYLENS 2 的系统语言时,应用名称也会相应切换。
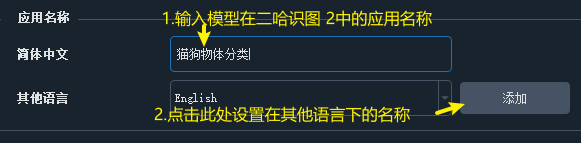
工具会为模型应用分配默认图标。你也可以点击 选择图标,选择本地图片作为该应用在 HUSKYLENS 2 中显示的图标。
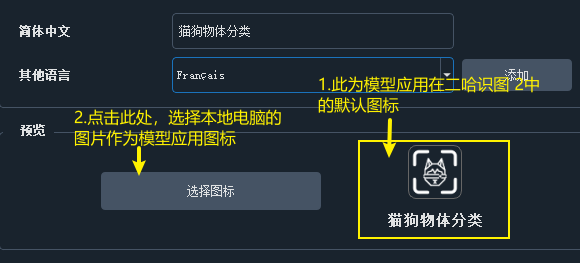
- 应用图标建议使用正方形、透明背景、白色线条的图片(与 HUSKYLENS 2 原生图标风格一致),也支持彩色图标;尺寸为 60 × 60 像素,选择其他尺寸的图片会被自动处理为 60 × 60。
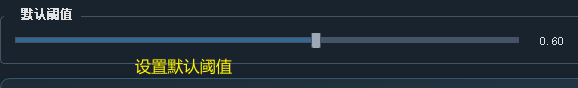
你还可以设置模型在 HUSKYLENS 2 中的默认识别阈值。
步骤五:生成模型安装包
完成以上设置后,点击 开始 生成模型安装包。在生成完成前,请勿关闭工具。
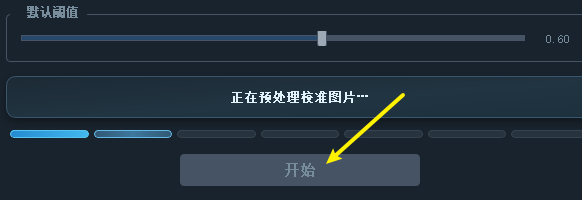
物体分类模型安装包生成成功后,会出现以下提示。
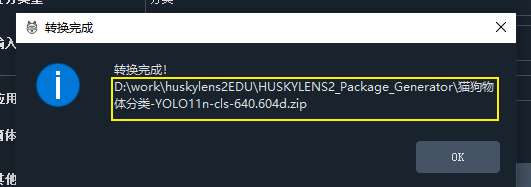
生成的物体分类模型安装包可在所选输出目录中找到。安装包命名格式为“应用名-模型版本-任务类型-输入尺寸.校验码.zip”。分类任务的任务类型为 cls,例如 Cat_Dog-YOLO11n-cls-640.xxxx.zip。
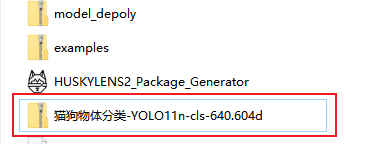
- 请勿修改生成的 ZIP 安装包,包括包内文件和安装包文件名,否则 HUSKYLENS 2 将无法识别该安装包。
5.5 将物体分类模型安装到 HUSKYLENS 2
生成安装包后,即可将其安装到 HUSKYLENS 2。操作步骤与目标检测模型相同:
使用 USB 线将 HUSKYLENS 2 连接到电脑,电脑上会出现一个名为 HUSKYLENS 2 的 U 盘。
把生成的 ZIP 安装包复制到 U 盘中的以下路径:
Huskylens\storage\installation_package
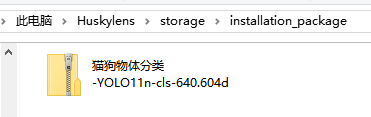
在 HUSKYLENS 2 屏幕上打开“模型安装(Model Installation)”,然后选择“本地安装(Local Installation)”。
安装完成后,你就可以在功能列表中找到自己训练的物体分类模型了。
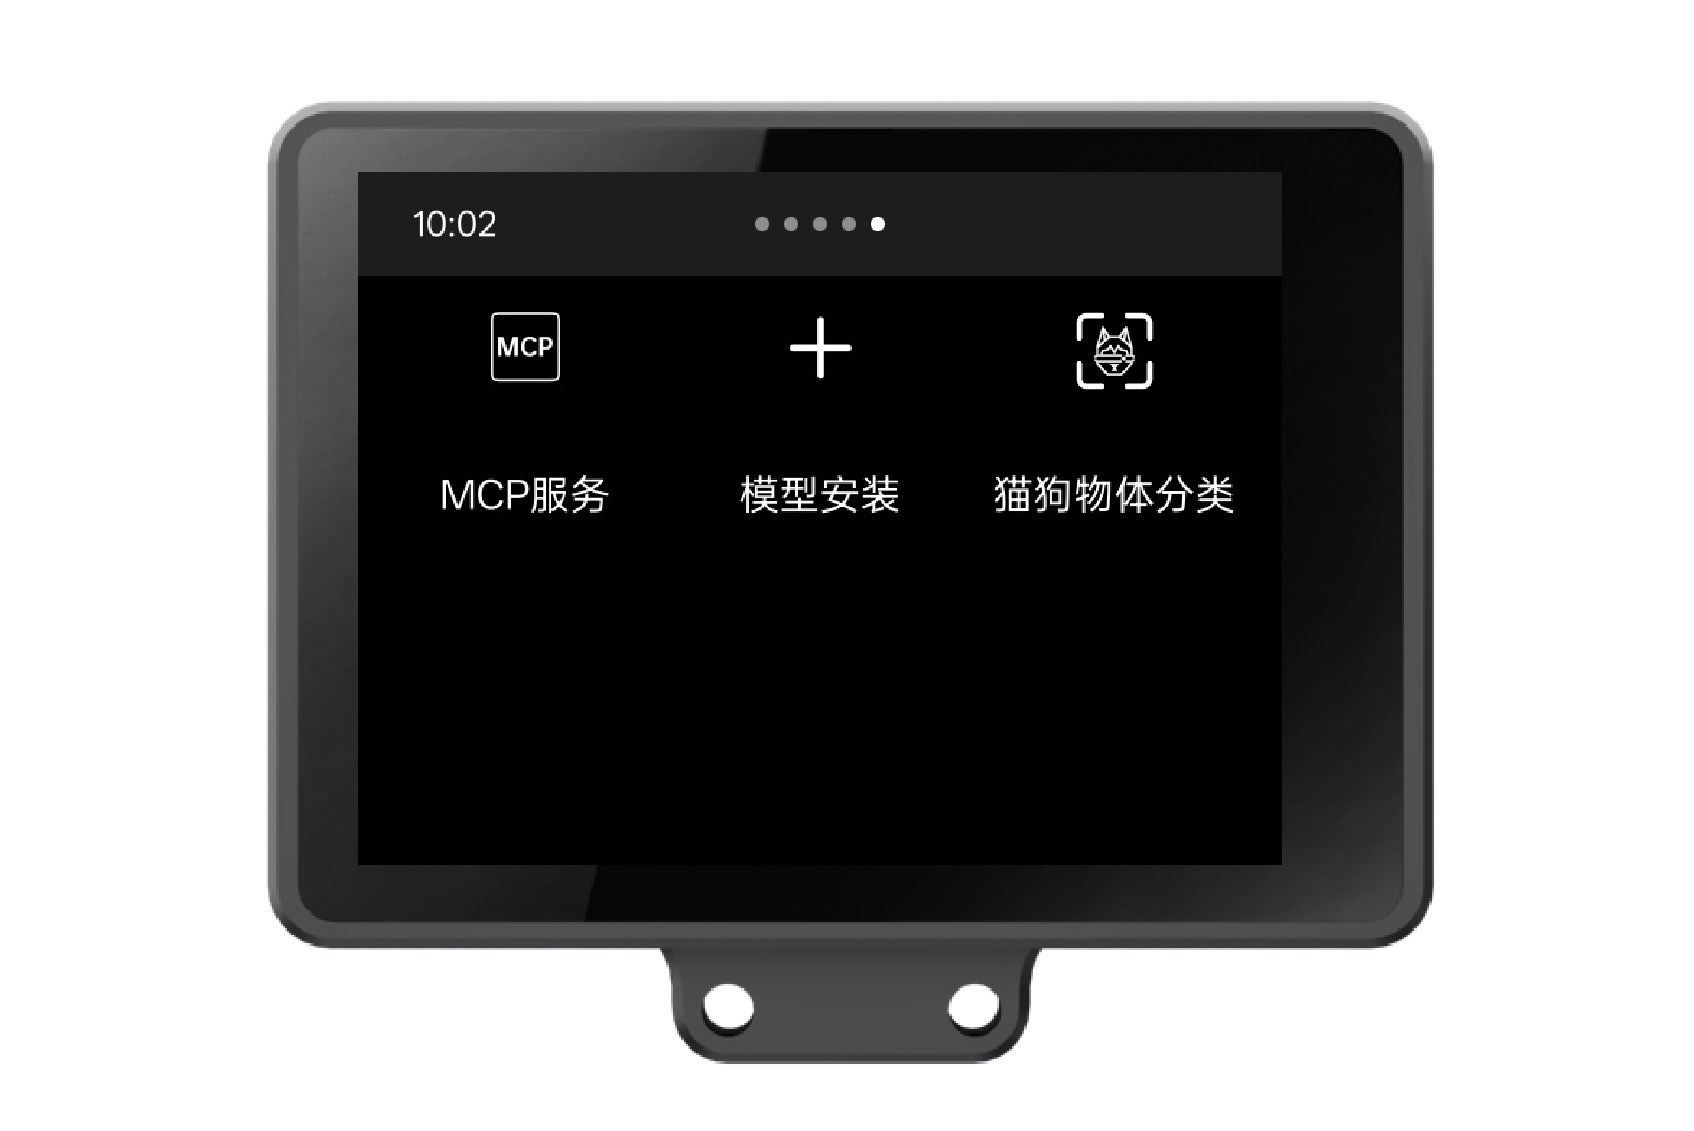
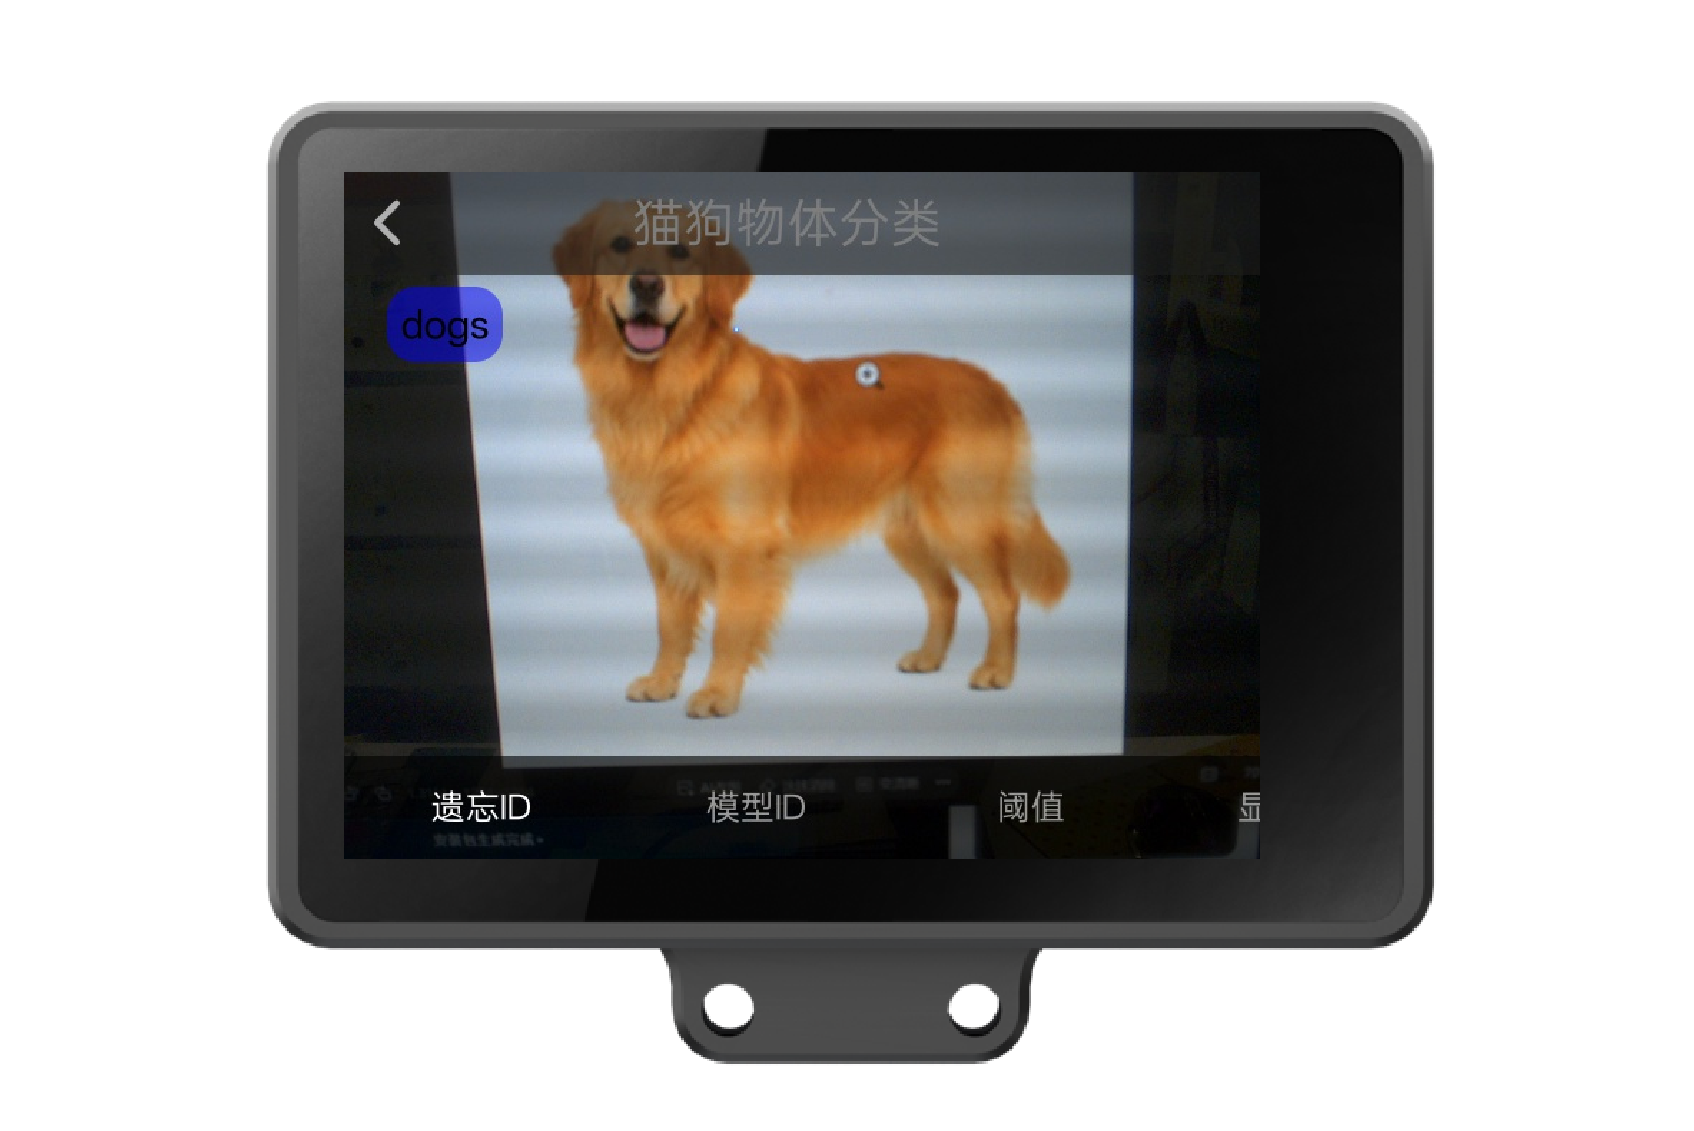
点击模型图标即可观察该模型的分类效果。以下是猫狗分类模型的分类效果。
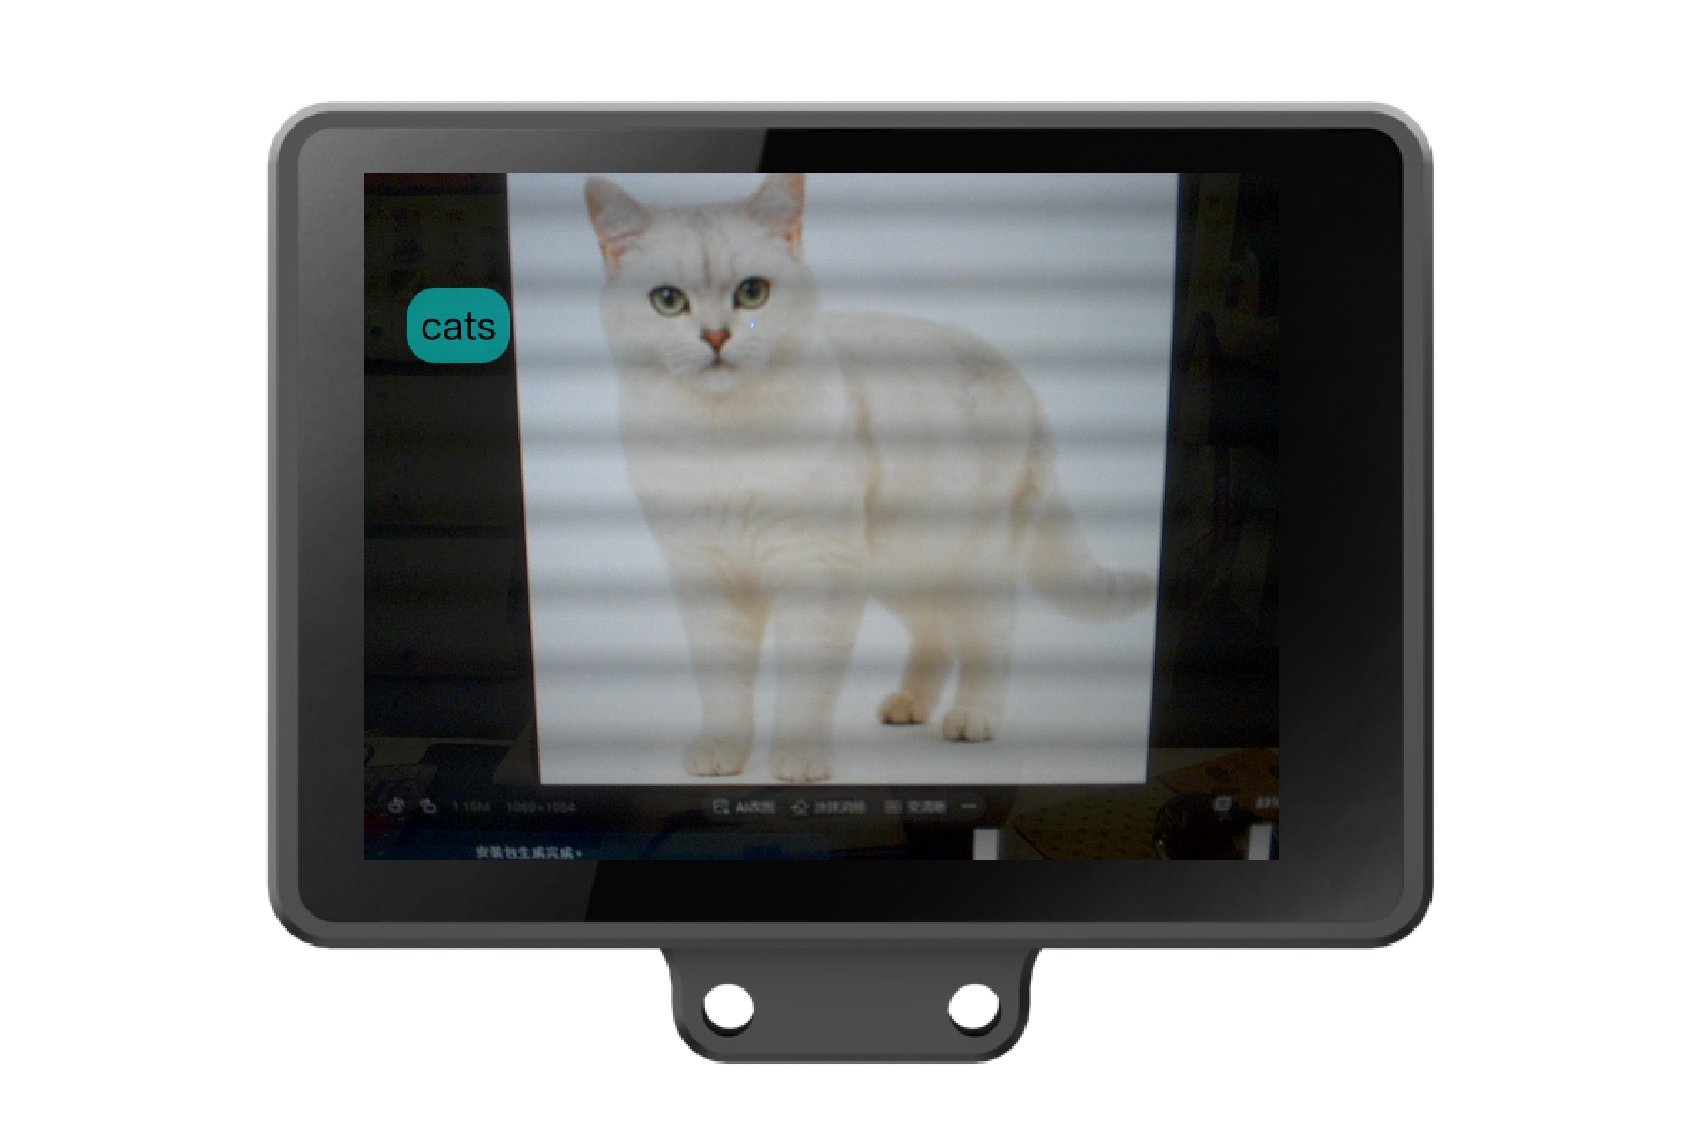
测试图片如下。
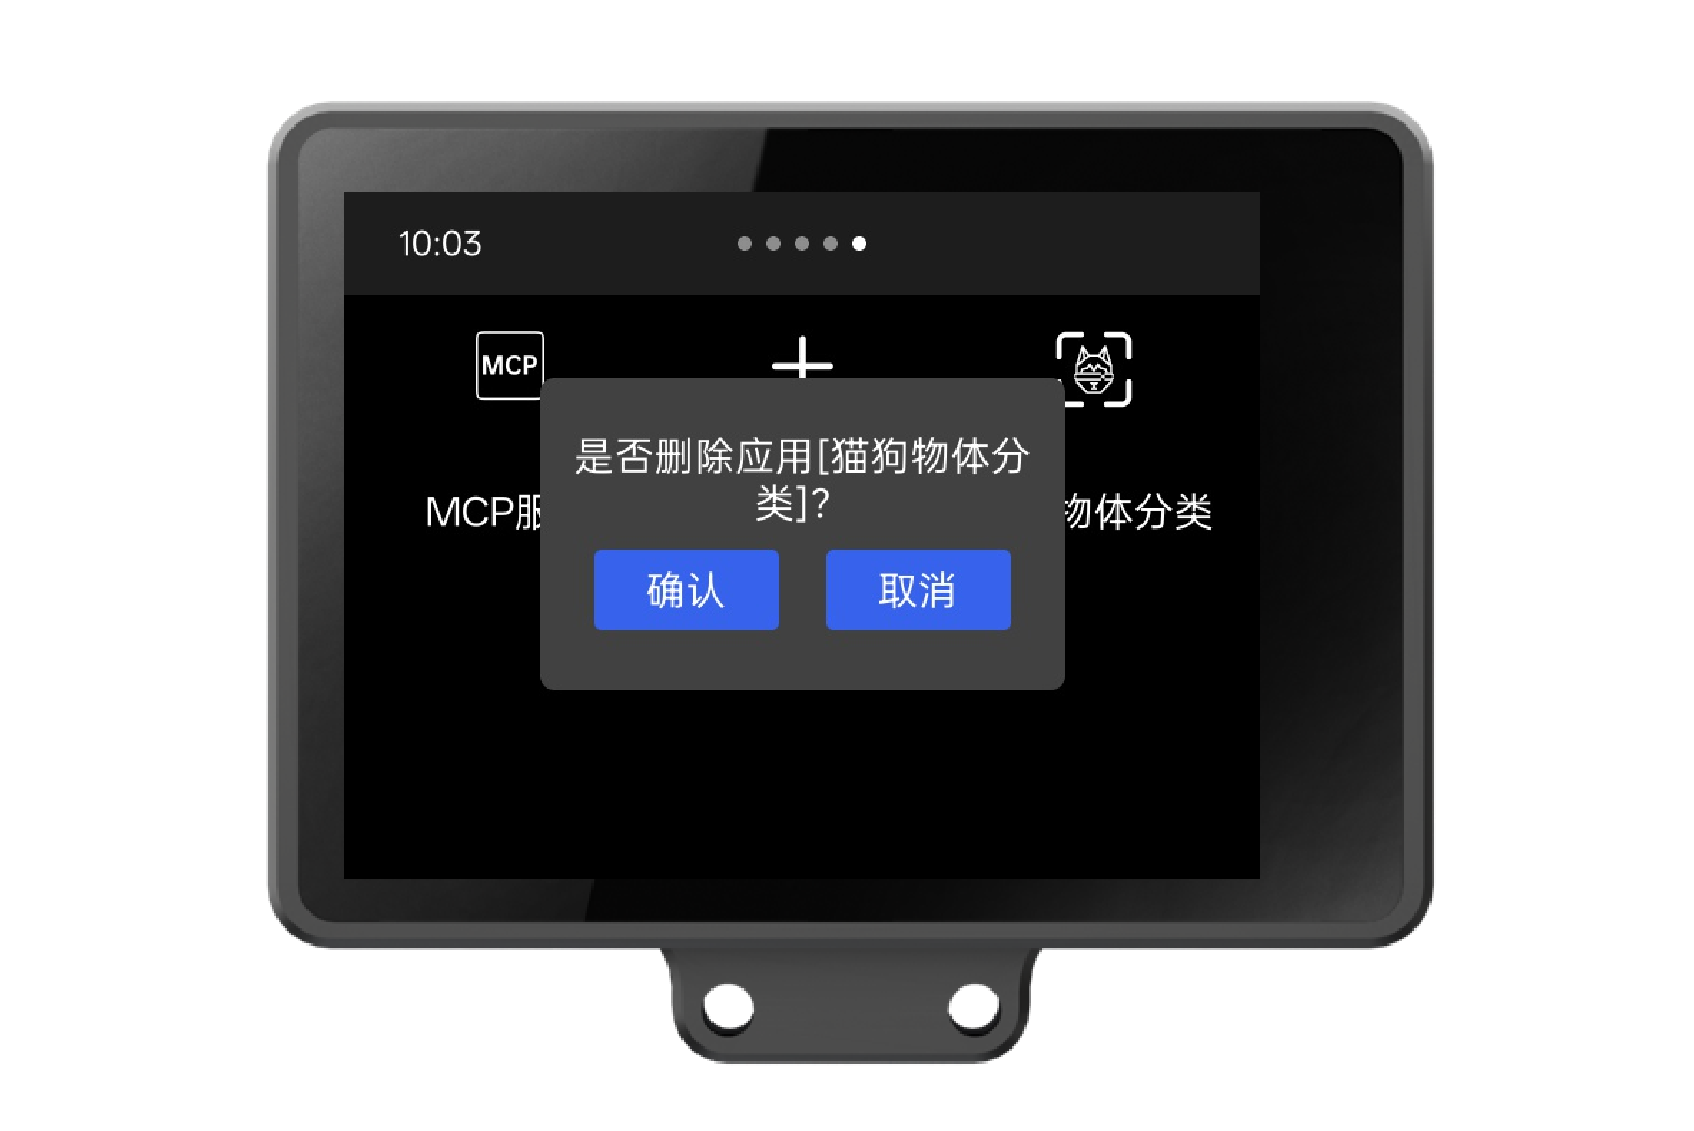
如需删除模型,请在屏幕上找到已部署的自训练模型,长按应用图标,然后按照屏幕提示确认删除。
6. 实例分割模型安装
实例分割(Instance Segmentation)在目标检测的基础上更进一步:它不仅能识别画面中的每个物体并框出位置,还能通过蒙版精确描绘物体轮廓。
例如,画面中有几朵花时,目标检测会用方框标出花的位置;实例分割则会沿每朵花的边缘生成彩色蒙版,并标注类别和置信度。你可以把它理解为“既标出位置,也描绘形状”。
实例分割模型的特点可以概括为:
- 每个目标都包含:位置框 + 精确轮廓(蒙版)+ 类别名称 + 置信度。
- 能精确描绘物体的形状,信息比目标检测更丰富。
- 适合“需要知道物体精确形状、轮廓”的场景,例如花朵分割、零件轮廓检测等。
HUSKYLENS 2 支持部署 YOLOv8n-seg 和 YOLO11n-seg 两种轻量级分割架构。下面就以 YOLO 实例分割模型为例,介绍如何训练并部署。
6.1 准备 YOLO 实例分割数据集
实例分割数据集的结构与目标检测数据集基本相同,同样由“图片 + 标签 + data.yaml”组成。区别在于:标签文件记录的是物体轮廓的多边形顶点坐标,而不是边界框。
一个标准的 YOLO 实例分割数据集,文件夹结构如下:
dataset_dir
├── data.yaml
├── images
│   ├── train
│   │   ├── image_001.jpg
│   │   └── ...
│   └── val                     # 建议保留;用于训练验证,转换时不会读取
│       └── ...
└── labels
    ├── train
    │   ├── image_001.txt
    │   └── ...
    └── val                     # 建议保留;用于训练验证,转换时不会读取
        └── ...
其中 data.yaml 的内容示例如下:
path: ./
train: ./images/train
val: ./images/val
names:
  0: flower
实例分割标签文件(.txt)与目标检测标签文件的内容不同:目标检测标签的每一行记录“类别 + 边界框中心坐标 + 宽高”(共 5 个数),实例分割标签的每一行则记录“类别 + 一组多边形顶点坐标”(class x1 y1 x2 y2 ... xn yn,至少 3 个点),由这些顶点勾勒物体轮廓。
模型安装包生成器不会读取验证集,但训练时建议保留 images/val 和 labels/val,用于评估模型效果。
这里提供了一个花朵分割数据集(Flower Segmentation Dataset),可直接用于实例分割模型训练:数据集和模型示例。
关于 YOLO 实例分割数据集更详细的格式说明,建议阅读 Ultralytics 官方教程:实例分割数据集。
6.2 训练实例分割模型
数据集准备好之后,就可以开始训练模型了。实例分割模型的训练同样使用 Ultralytics 库,如果你还不熟悉,可以先参考 Ultralytics 官方入门教程:快速入门。
请特别注意以下两点:
- HUSKYLENS 2 仅支持架构为 YOLOv8n-seg 和 YOLO11n-seg 的自训练分割模型,其他架构都不支持,训练时请只在这两类里选择。
- HUSKYLENS 2 仅支持 224 × 224、320 × 320 和 640 × 640 这三种输入尺寸。训练时选择的输入尺寸,应与后面生成安装包时保持一致。
下面给出完整的训练代码示例,只需将其中的路径替换为实际路径:
from ultralytics import YOLO

if __name__ == "__main__":
    # 加载预训练分割模型
    # HUSKYLENS 2 仅支持 "yolov8n-seg.pt" 和 "yolo11n-seg.pt" 两种,请勿使用其他型号
    model = YOLO("yolov8n-seg.pt")   # 也可以换成 "yolo11n-seg.pt"

    # 训练模型
    # data  : 数据集配置文件 data.yaml 的路径,请替换成实际路径
    # epochs: 训练轮数,可先从 30 开始;轮数过少可能训练不足,过多也可能导致过拟合
    # imgsz : 输入图片尺寸,HUSKYLENS 2 仅支持 224 / 320 / 640
    results = model.train(
        data="path/to/data.yaml",   # 例如 r"D:\...\Flower Segmentation Dataset\data.yaml"
        epochs=30,
        imgsz=640,
    )
训练完成后,Ultralytics 默认会在 runs/segment/train/weights/ 目录下生成模型权重文件,其中 best.pt 是效果最好的模型。如果已有同名训练目录,系统可能会自动生成 train2、train3 等带编号的目录。
6.3 导出实例分割 ONNX 模型
训练得到的是 .pt 格式的模型文件,而 HUSKYLENS 2 的模型安装需要 ONNX 格式的模型。因此还需要把 .pt 转换成 .onnx。转换代码如下:
from ultralytics import YOLO

if __name__ == "__main__":
    # 加载训练好的分割模型权重(请替换成你的 best.pt 实际路径)
    model = YOLO("path/to/best.pt")   # 例如 r"D:\...\runs\segment\train\weights\best.pt"

    # 导出为 ONNX 格式,导出后会在同目录下生成 best.onnx
    # imgsz 需与训练时的输入尺寸保持一致(224 / 320 / 640)
    model.export(format="onnx", imgsz=640)
执行成功后,best.pt 所在目录中会生成 best.onnx 文件,后续生成安装包时将使用该文件。
你可以使用数据集和模型示例,参考上方代码训练花朵分割模型。下载的样例文件中还包含已经训练并导出的 ONNX 模型。
关于训练和导出教程,请参考 Ultralytics 官方分割任务教程:Instance Segmentation。
6.4 生成实例分割模型安装包
训练并导出 ONNX 模型后,同样需要将其打包为 HUSKYLENS 2 能够识别的 ZIP 安装包。这里使用的仍是第 3 节介绍的 HUSKYLENS 2 模型安装包生成器。
6.4.1 准备 HUSKYLENS 2 模型安装包生成器
如果尚未安装 .NET 7.0 或下载模型安装包生成器,请先按照第 3 节“软件与硬件准备”完成操作。
6.4.2 生成 HUSKYLENS 2 实例分割模型安装包
完成第 3 节的软件与硬件准备后,双击运行 HUSKYLENS2_Package_Generator.exe。工具界面如下。
HUSKYLENS2_Package_Generator 的各功能区域及操作步骤如下。
下面以花朵分割为例,演示生成实例分割模型安装包的完整流程。如果你想跟随示例操作,请下载数据集和模型示例。
开始之前,请先在工具顶部完成以下三项基础设置:
- 选择界面语言:切换到你习惯的语言(支持 English、简体中文、繁體中文等八种语言)。
- 选择输出目录:选择安装包的保存位置,生成的 ZIP 安装包将保存到该目录。
- 选择数据来源:保持默认的 YOLO 即可。
步骤一:选择数据集文件夹
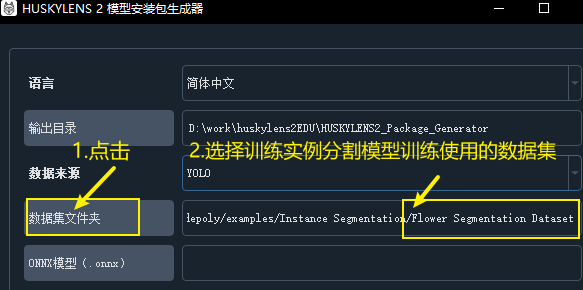
点击 数据集文件夹,选择并加载包含 data.yaml 的分割数据集文件夹。使用样例数据集时,请选择 sample_datasets/Instance Segmentation/Flower Segmentation Dataset 文件夹。
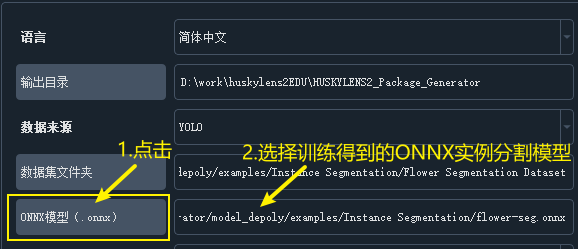
步骤二:选择 ONNX 模型
点击 ONNX 模型,选择并加载使用该数据集训练并导出的分割 ONNX 模型文件。使用样例模型时,请选择 sample_datasets/Instance Segmentation/flower-seg.onnx。
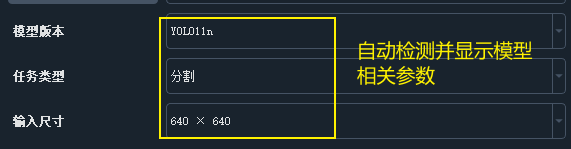
步骤三:确认模型参数信息
加载模型后,工具会自动检测并显示相关参数。请检查参数是否正确,并确认其与训练时的设置一致。对于分割任务,请确认“任务类型”显示为“分割”。
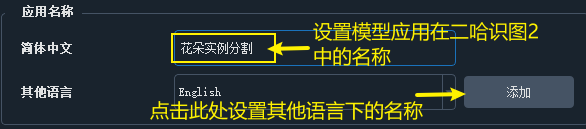
步骤四:完成模型应用在 HUSKYLENS 2 中的相关设置
-
在 应用名称 中设置模型部署到 HUSKYLENS 2 后显示的应用名称,例如
花朵实例分割。 -
手动换行:输入框输入应用名称时,按 Enter 会插入
\n换行符。 -
自动换行:每行最多显示 12 个半角字符或 6 个全角字符,超出部分会自动换行,最多显示两行。
-
点击 添加 可设置其他语言对应的应用名称;用户可添加八种语言中的其他语言名称;未单独填写的语言使用当前默认名称补齐;切换 HUSKYLENS 2 的系统语言时,应用名称也会相应切换。
工具会为模型应用分配默认图标。你也可以点击 选择图标,选择本地图片作为该应用在 HUSKYLENS 2 中显示的图标。
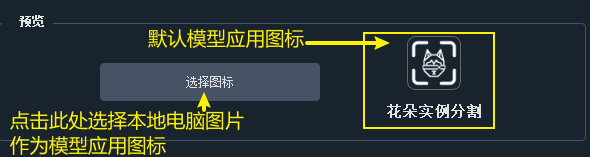
- 应用图标建议使用正方形、透明背景、白色线条的图片(与 HUSKYLENS 2 原生图标风格一致),也支持彩色图标;尺寸为 60 × 60 像素,选择其他尺寸的图片会被自动处理为 60 × 60。
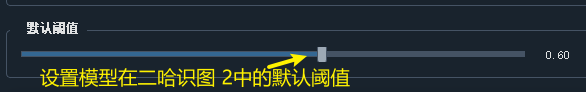
你还可以设置模型在 HUSKYLENS 2 中的默认识别阈值。
步骤五:生成模型安装包
完成以上设置后,点击 开始 生成模型安装包。在生成完成前,请勿关闭工具。
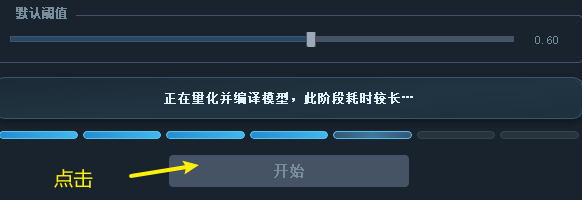
实例分割模型安装包生成成功后,会出现以下提示。
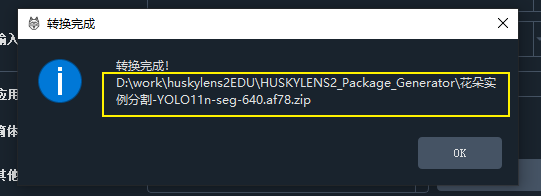
生成的实例分割模型安装包可在所选输出目录中找到。安装包命名格式为“应用名-模型版本-任务类型-输入尺寸.校验码.zip”。分割任务的任务类型为 seg,例如 Flower-YOLO11n-seg-640.xxxx.zip。
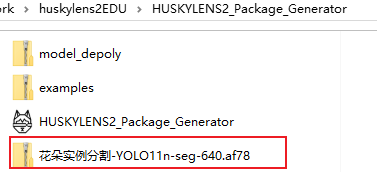
- 请勿修改生成的 ZIP 安装包,包括包内文件和安装包文件名,否则 HUSKYLENS 2 将无法识别该安装包。
6.5 将实例分割模型安装到 HUSKYLENS 2
生成安装包后,即可将其安装到 HUSKYLENS 2。操作步骤与目标检测、物体分类模型相同:
使用 USB 线将 HUSKYLENS 2 连接到电脑,电脑上会出现一个名为 HUSKYLENS 2 的 U 盘。
把生成的 ZIP 安装包复制到 U 盘中的以下路径:
Huskylens\storage\installation_package
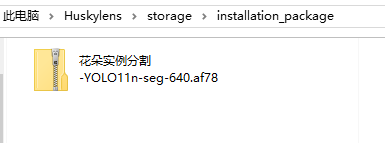
在 HUSKYLENS 2 屏幕上打开“模型安装(Model Installation)”,然后选择“本地安装(Local Installation)”。
安装完成后,你就可以在功能列表中找到自己训练的实例分割模型了。
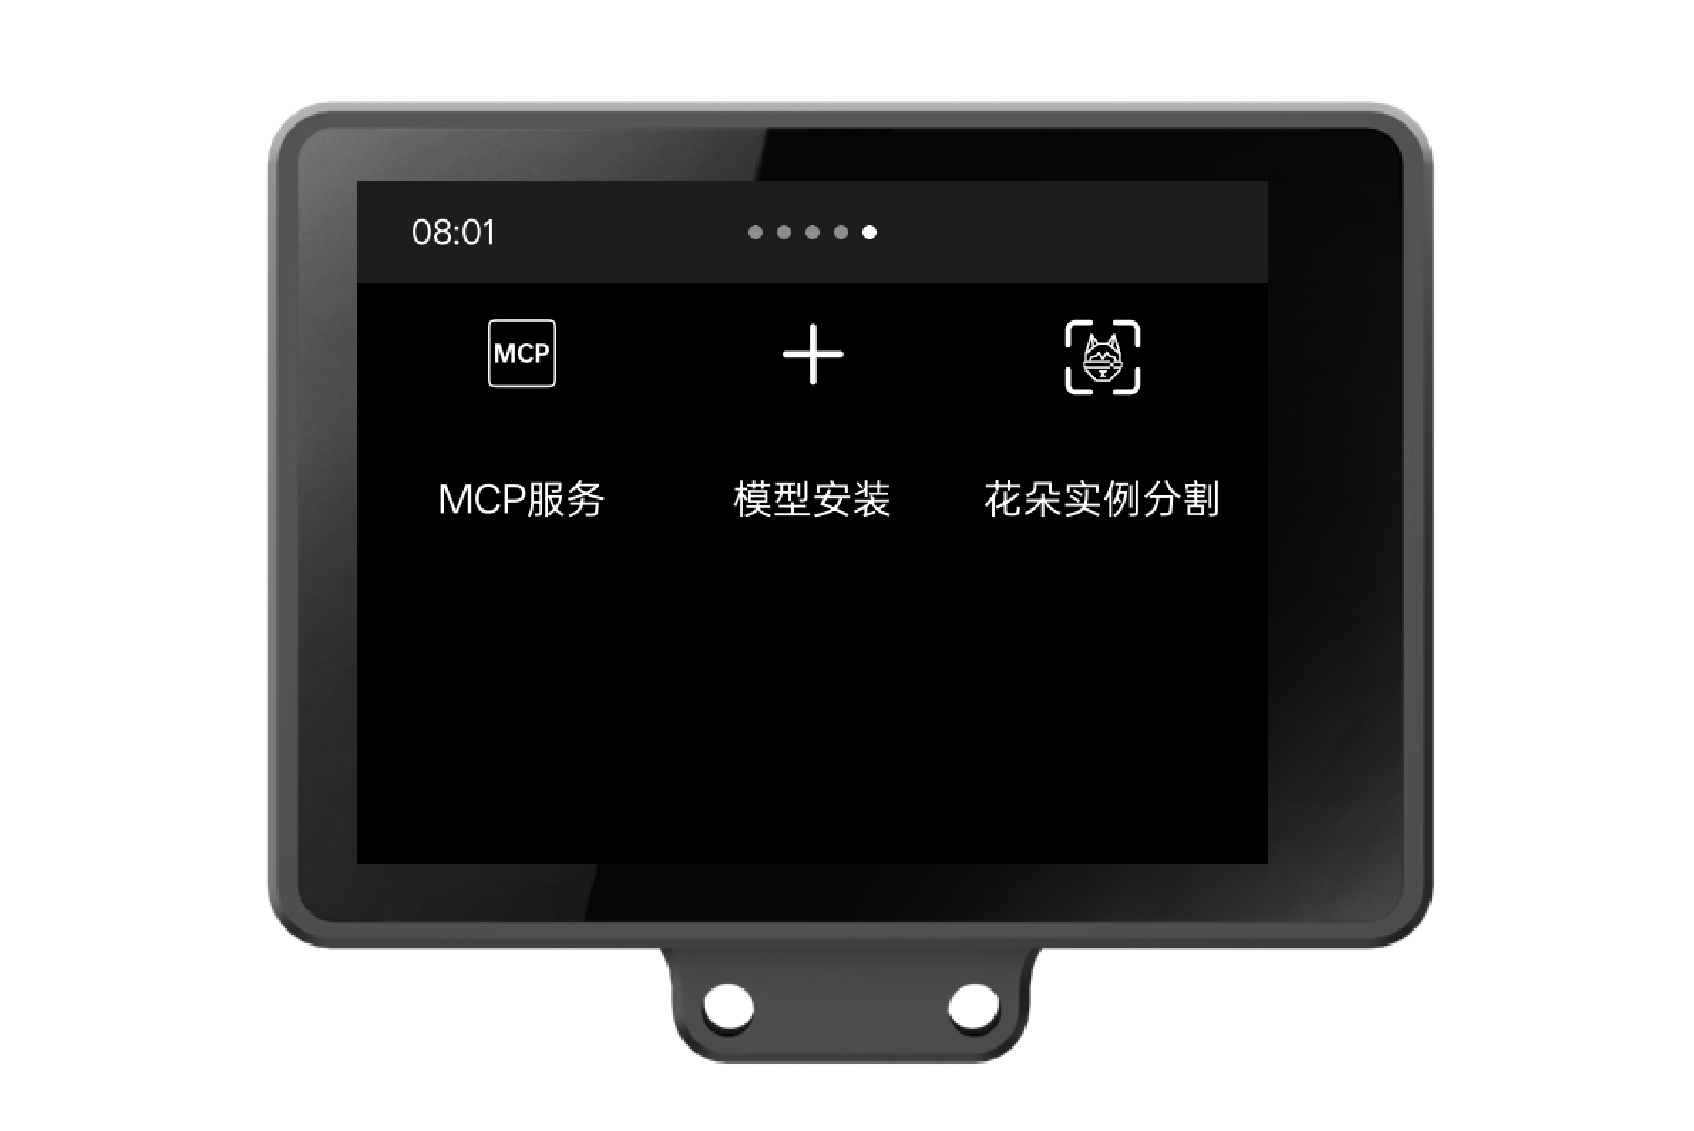
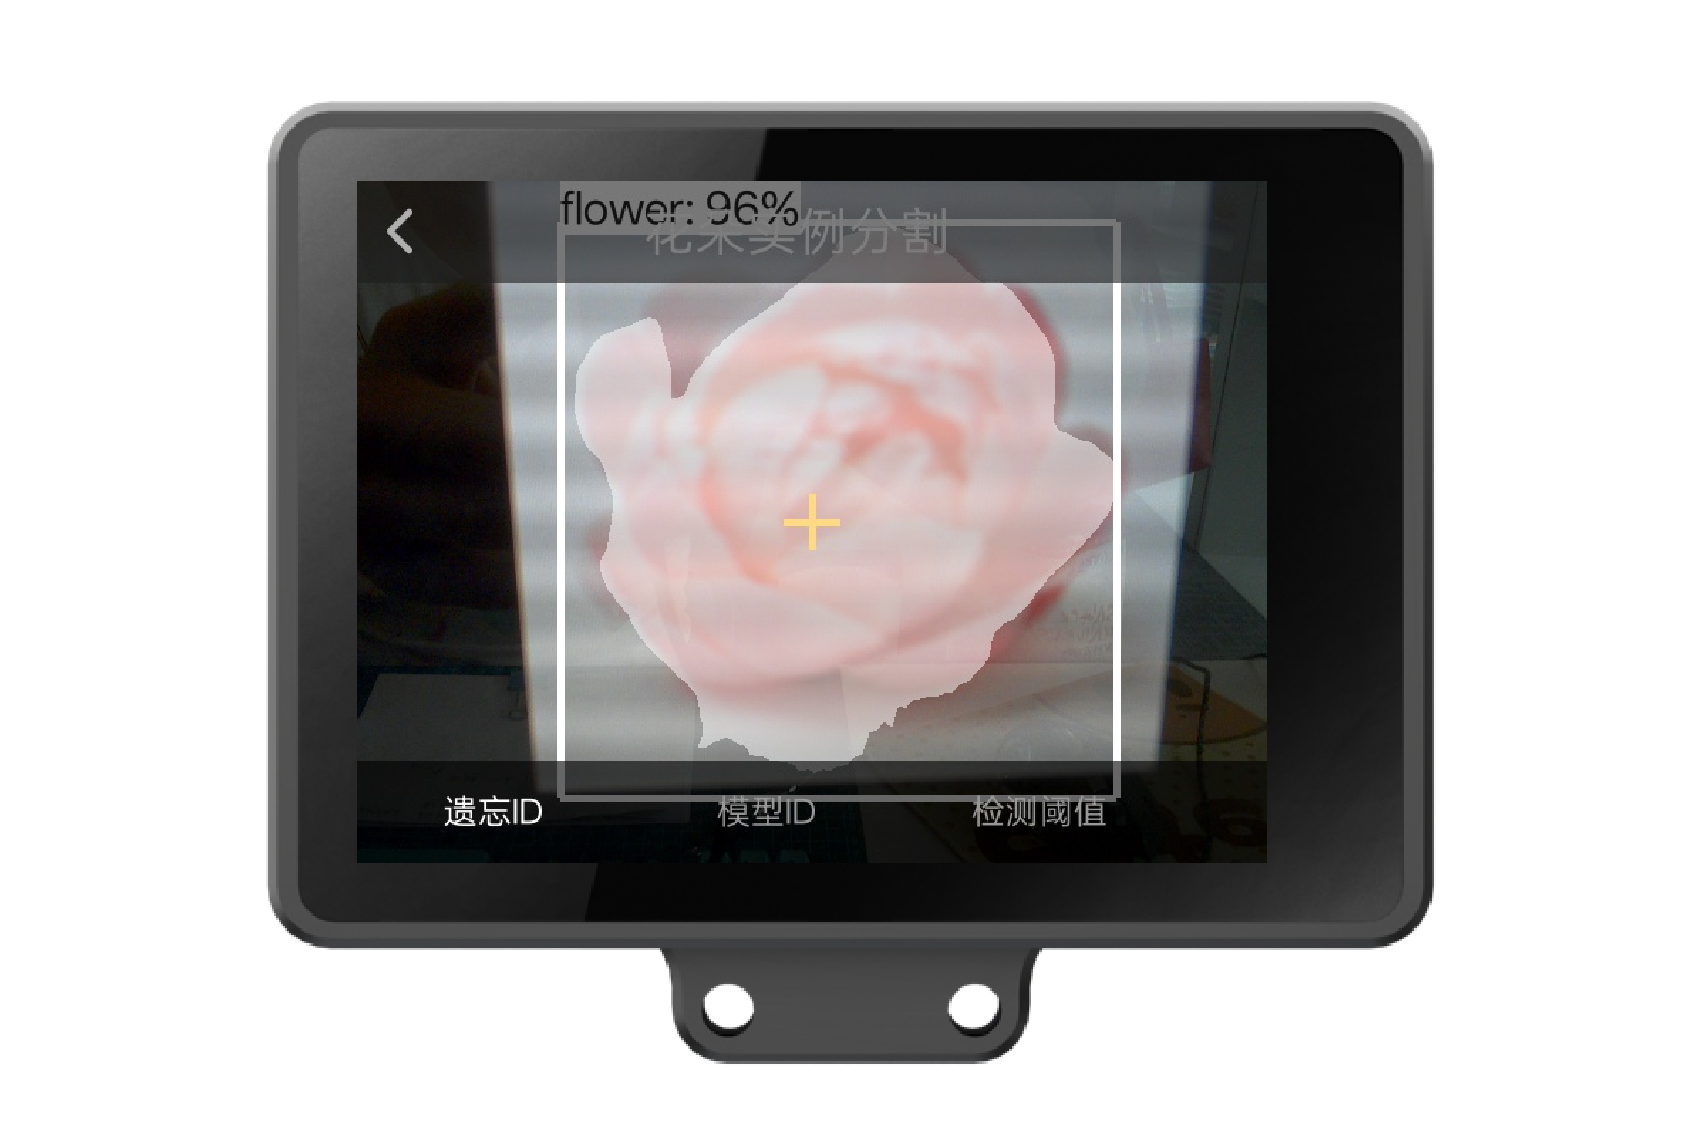
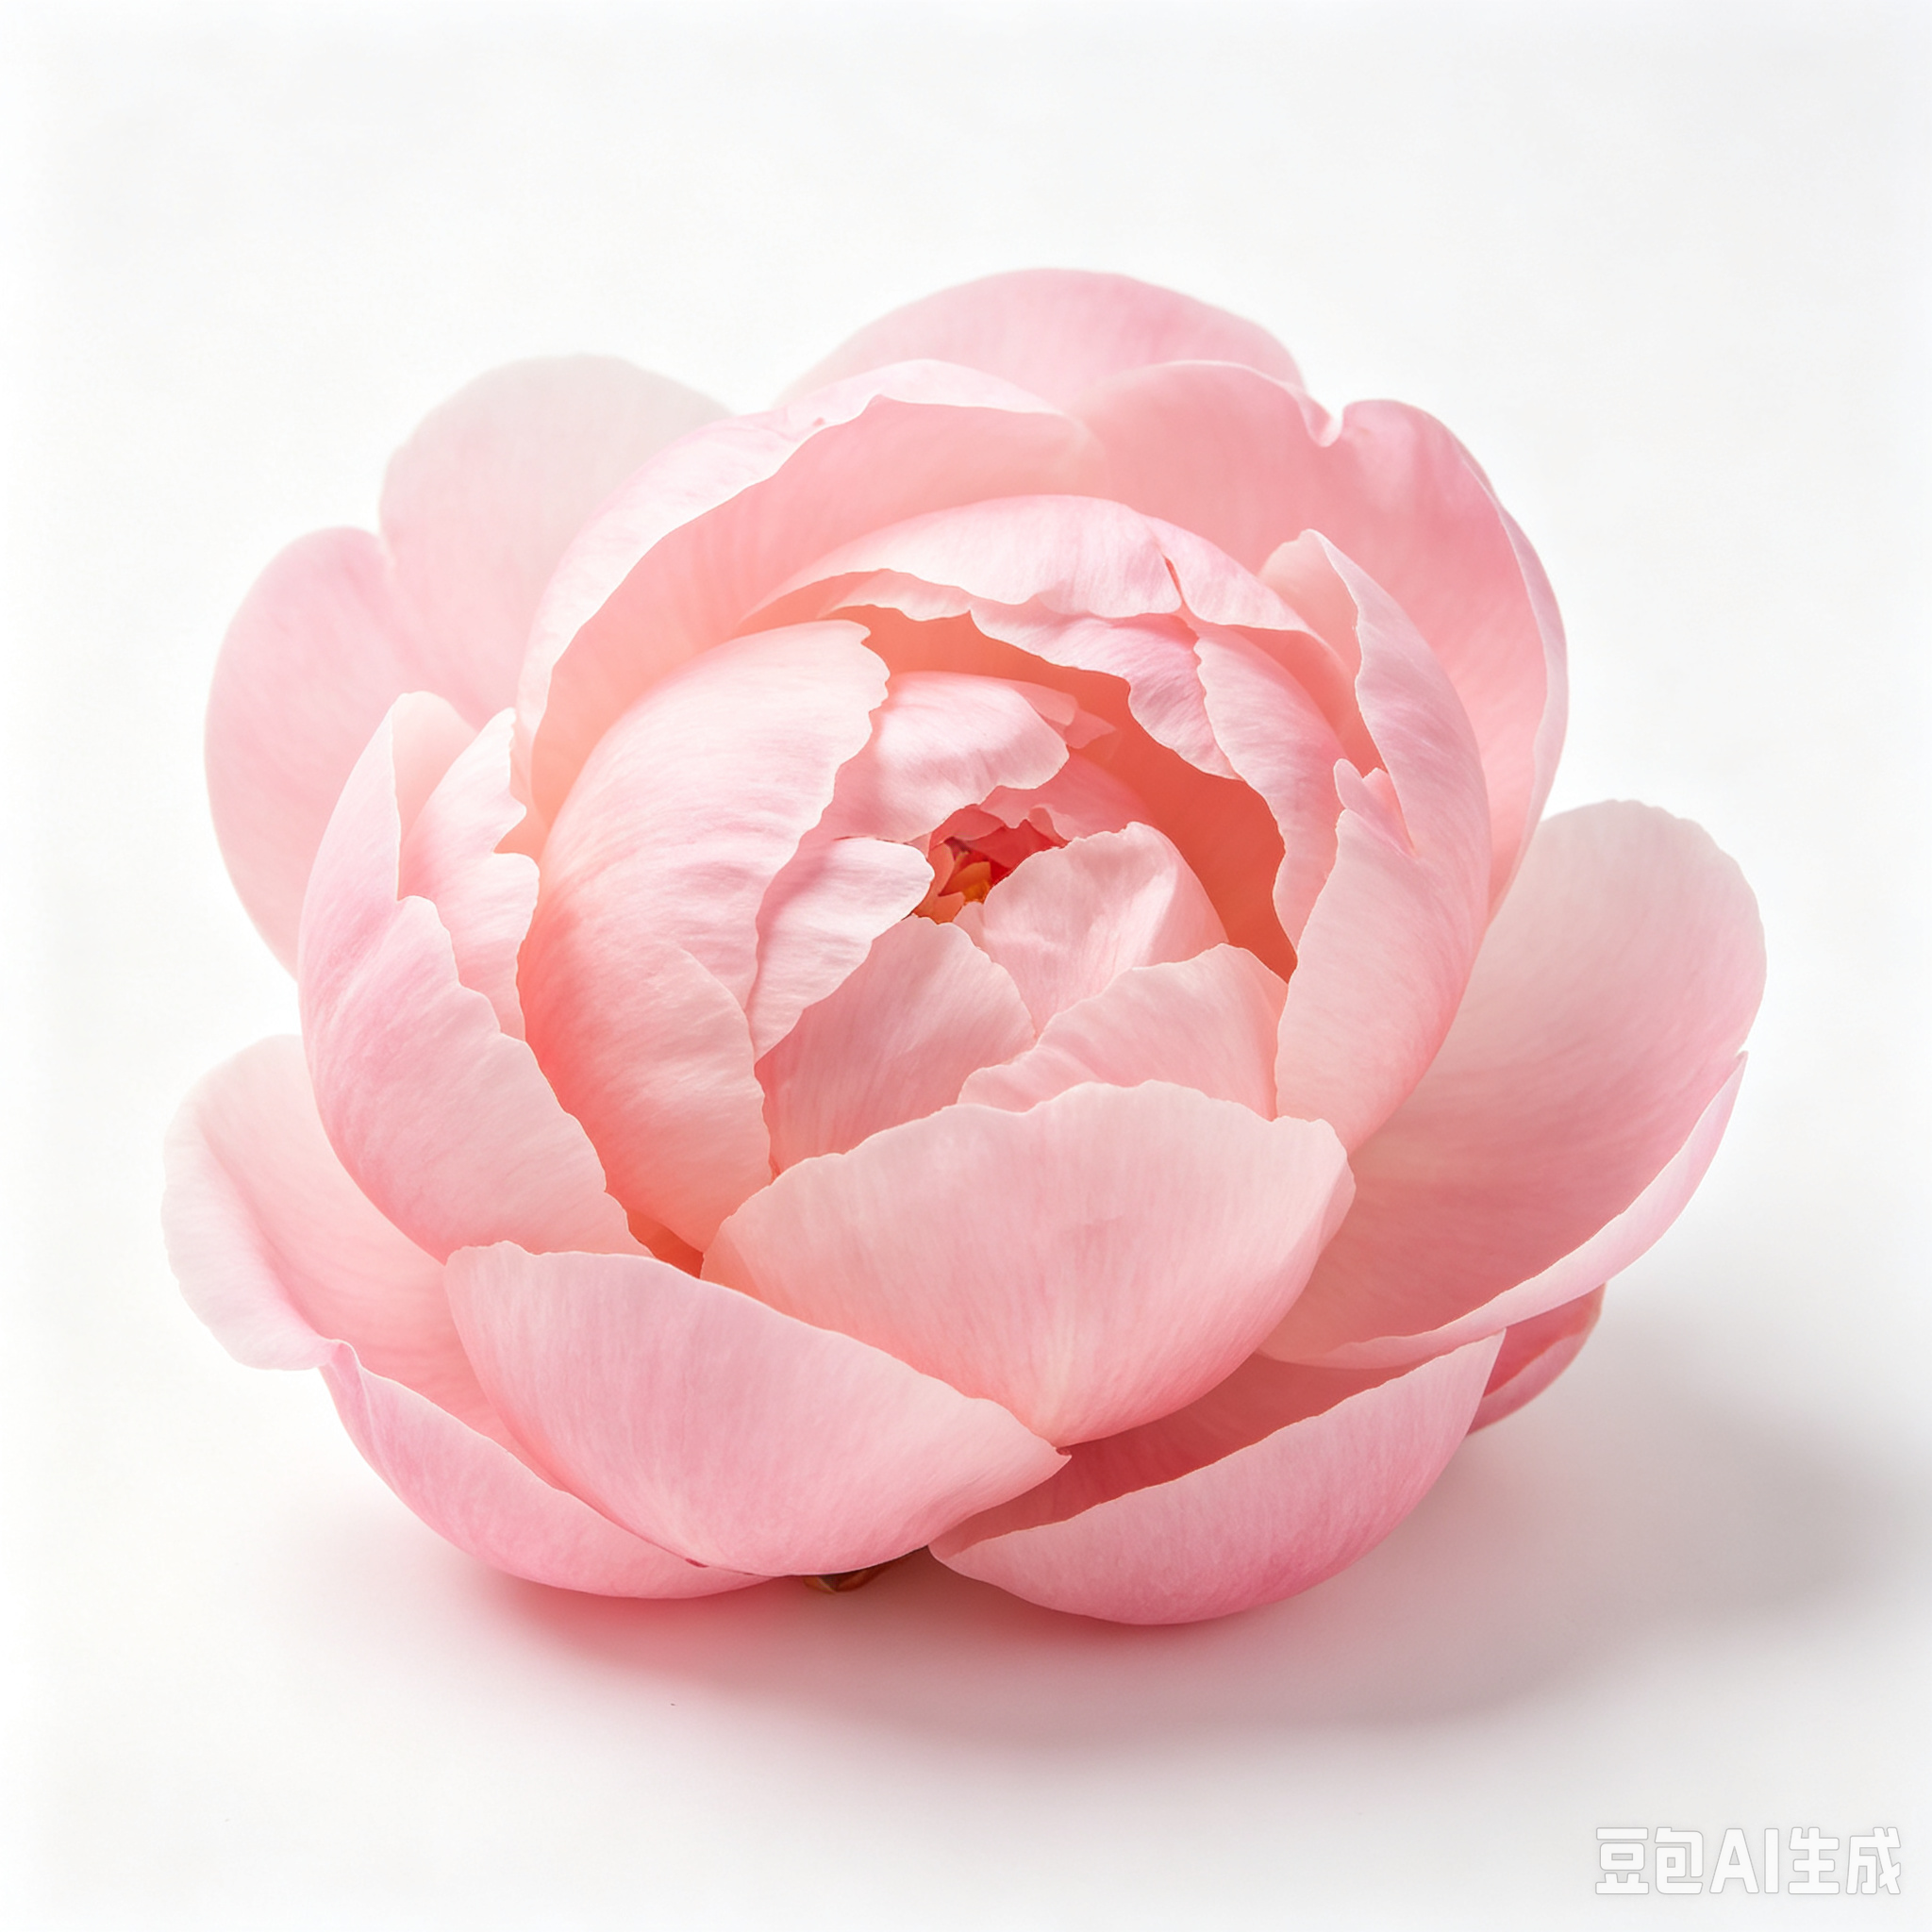
点击模型图标即可观察该模型的识别效果。以下是花朵分割模型的分割效果。
测试图片如下。
如需删除模型,请在屏幕上找到已部署的自训练模型,长按应用图标,然后按照屏幕提示确认删除。